黑板架构:当多个 Agent 面对没有标准答案的问题
黑板架构:当多个 Agent 面对没有标准答案的问题
引子:真正的难题不是"怎么把任务分下去"
搭多 Agent 系统时,最直觉的做法是 Manager-Worker:把一个大任务拆成有依赖关系的子任务,分给不同 Worker,再汇总结果。需求明确、路径已知时,这招很好用——写个报表导出功能,就拆成需求分析、接口实现、测试、代码审查,按部就班。
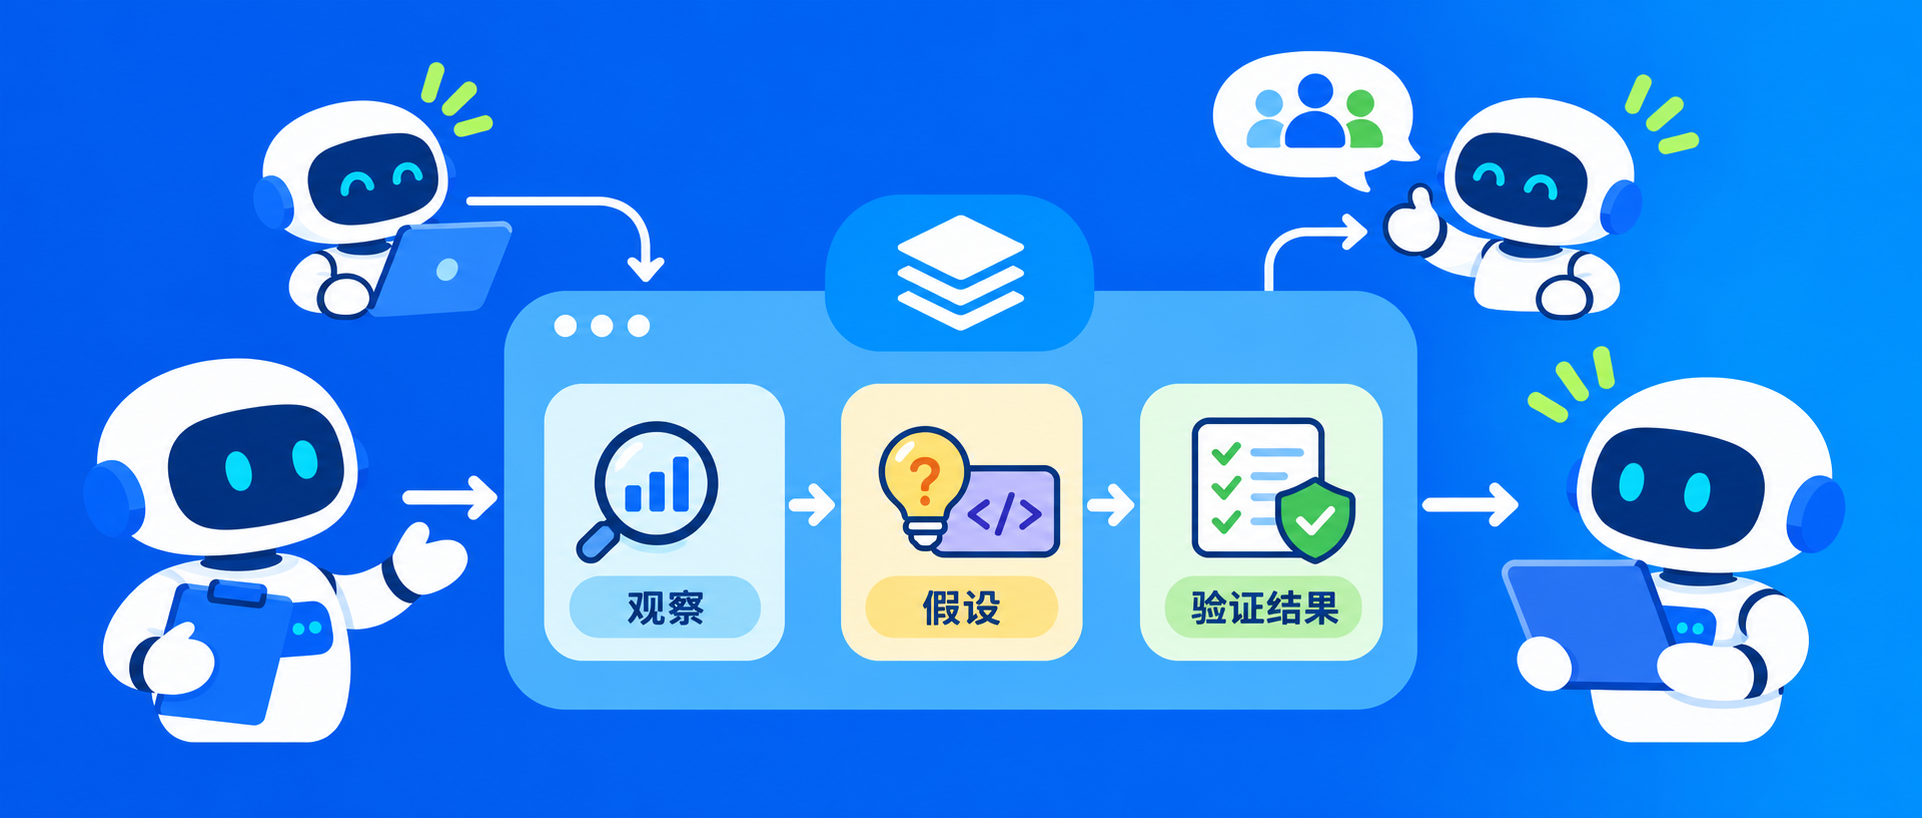
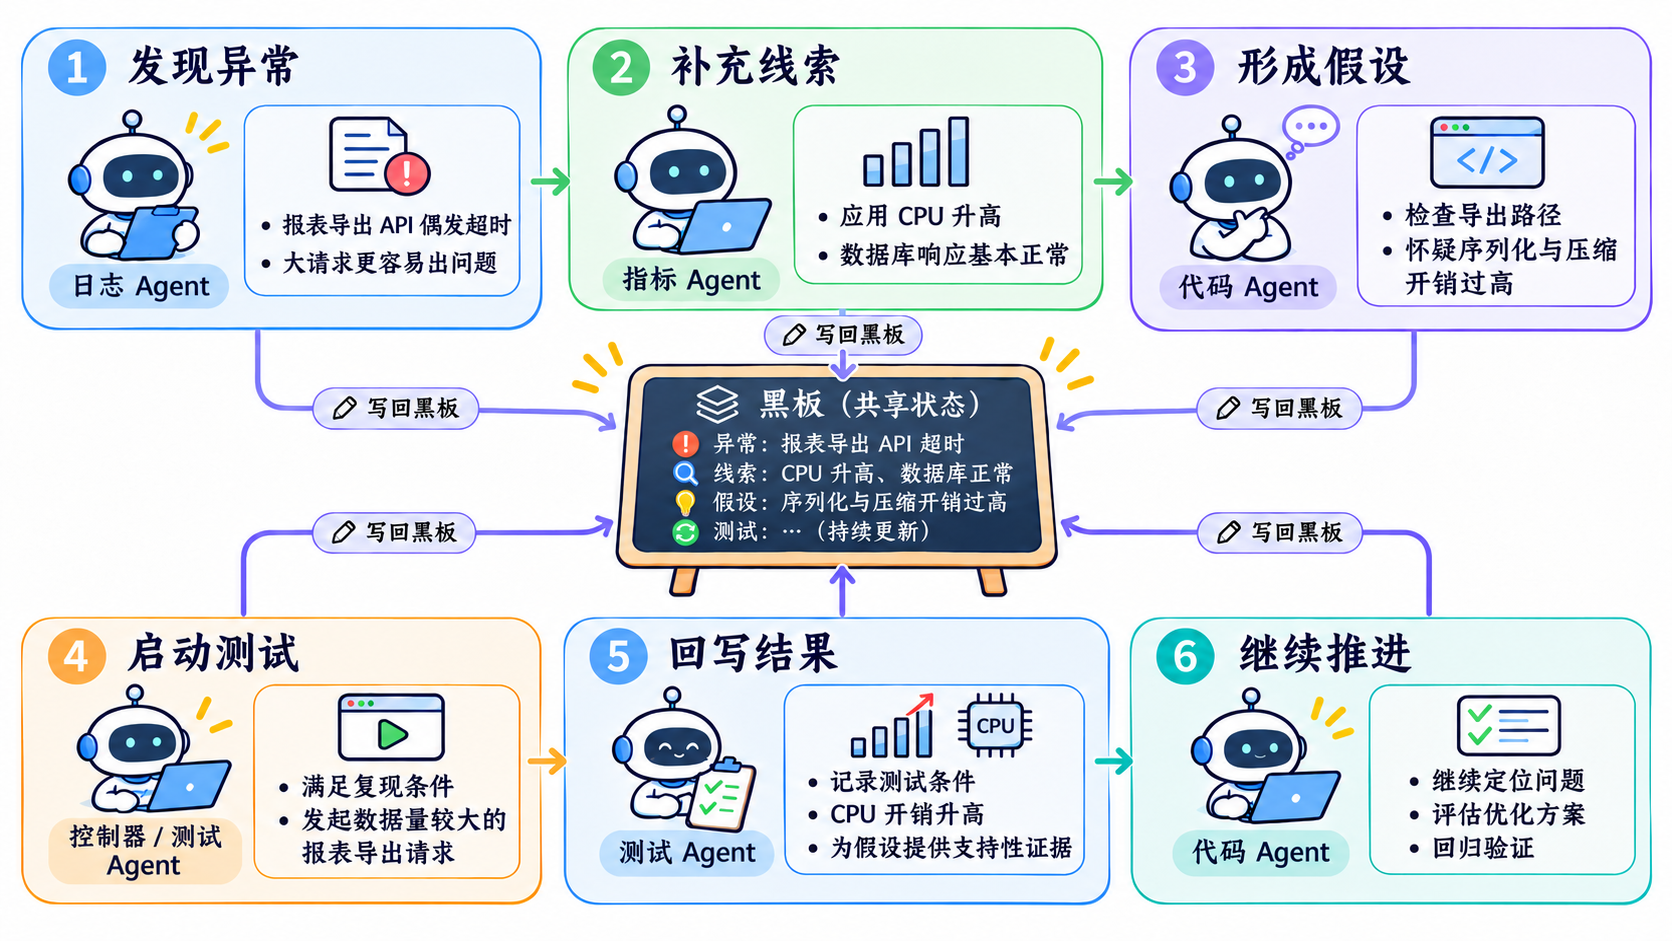
但有一类任务不是这样。比如排查"报表导出 API 偶发超时":目标很明确,路径却完全未知。日志 Agent 发现大请求更易超时,指标 Agent 发现应用 CPU 升高而数据库正常,代码 Agent 找到同步序列化与压缩的可疑路径。每出现一条新线索,下一步调查方向就可能被改写。
这时候真正的瓶颈不是"谁干哪块",而是两个问题:
- 一个新发现,怎样变成所有参与者都能使用的共同依据?
- 当前信息下,该由谁继续推进?
黑板架构(Blackboard Architecture)给出的答案是:不要让 Agent 互相传话,让它们围绕同一份 evolving 的问题状态工作。
一、这个答案并不新:一次被重新发现的老思路
黑板架构不是 Agent 时代的新发明。它最早于 1973—1976 年在卡内基梅隆大学的 HEARSAY-II 语音理解系统中创立,1980 年 Erman、Hayes-Roth、Lesser 与 Reddy 在 Artificial Intelligence 第 14 卷发表了对该模型的完整描述,后来又在 HEARSAY-III 中被泛化为通用问题求解框架,Hayes-Roth 在 1985 年的 BB1 中进一步把"控制知识"本身也放上了黑板。
为什么是语音识别催生了它?因为语音理解天然需要声学、音素、词、句法、语义多个层级的知识共同作用,而且低层的错误要靠高层的上下文来纠正。流水线式处理一旦前级出错,后级只能将错就错;而让所有专家围着一块"黑板"看当前的最佳解释,谁发现新证据谁就往上写,其他专家再据此修订自己的判断——这就是所谓的机遇式问题求解(Opportunistic Problem Solving)。
今天的多 Agent 复杂任务,遇到的正是同构的问题:非单调推理、多专业协作、执行顺序无法事先确定。
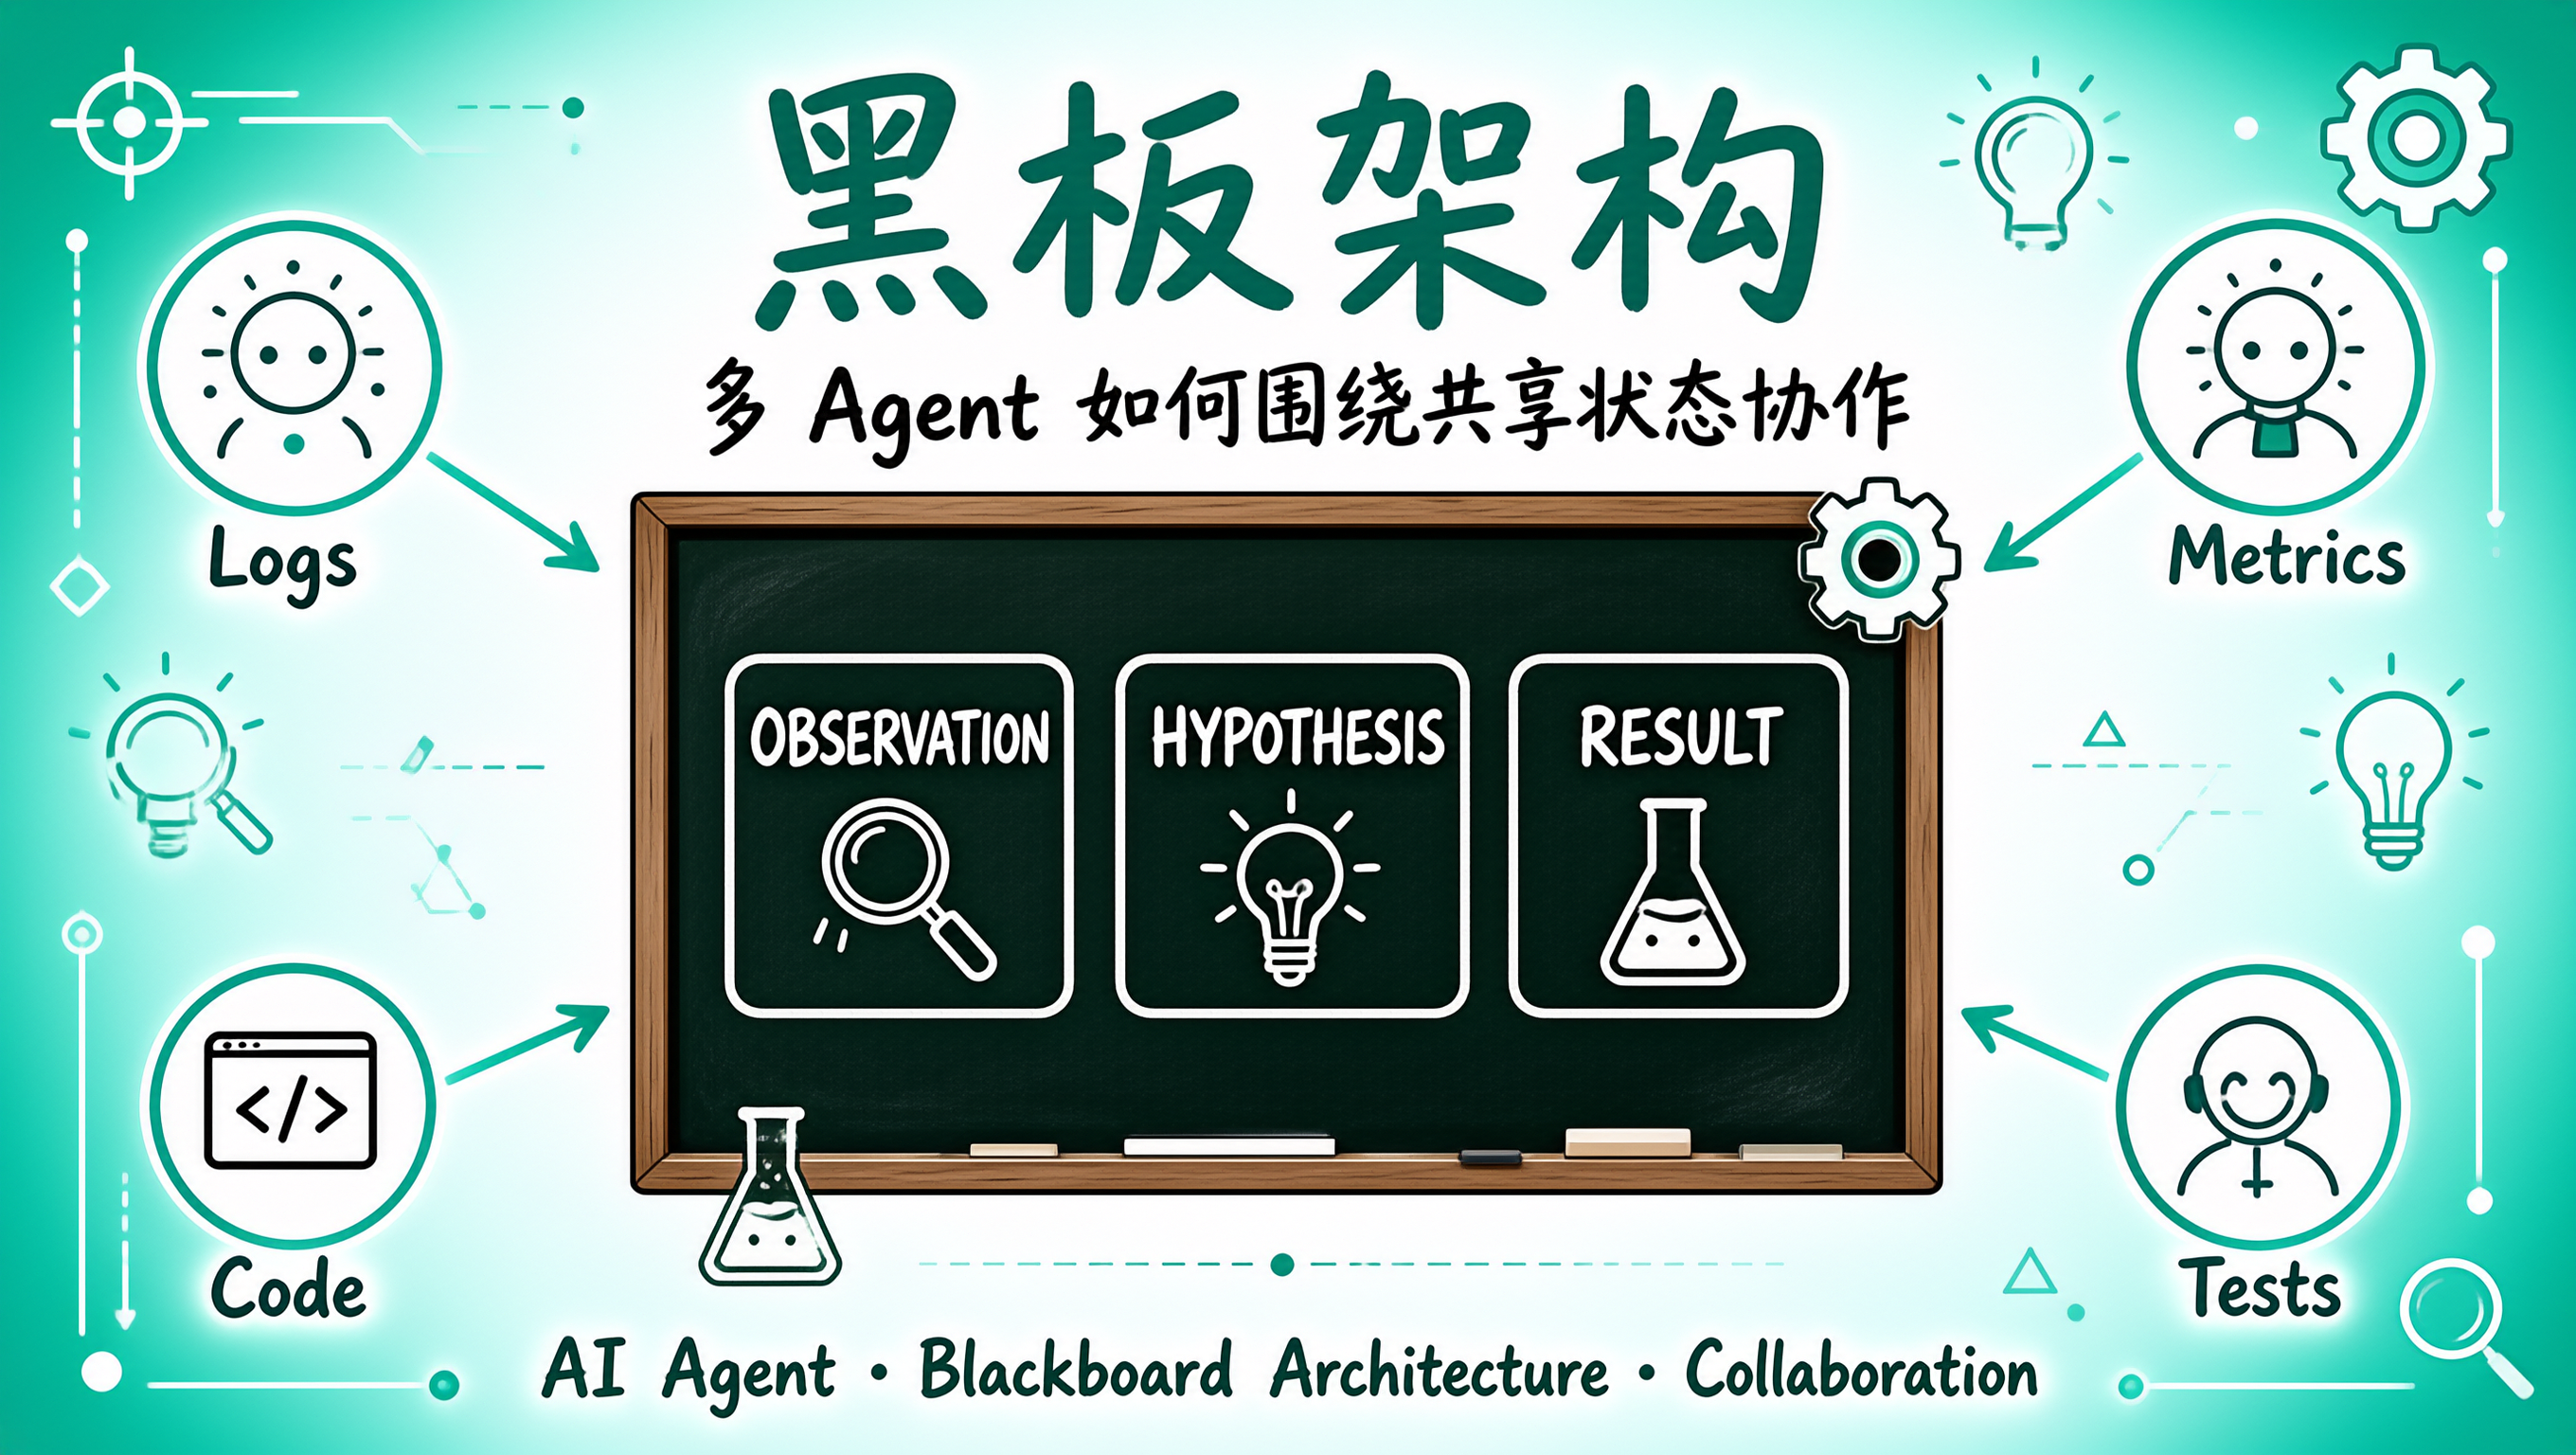
经典黑板模型由三部分组成:
- 知识源(Knowledge Source):各有所长的独立专家,彼此不直接通信;
- 黑板:分层组织的共享工作区,存放问题和求解过程中的中间状态;
- 控制机制(Controller / Scheduler):根据黑板状态和各知识源的激活条件,决定下一步激活谁。
我的理解是,这里真正关键的设计是把"专业知识"和"协调逻辑"拆开了。一个知识源只需要回答"我能贡献什么",控制器回答"现在该谁上"。因此,新增一个专业 Agent 的成本,不是去改动它与所有其他 Agent 的通信关系,而是注册一组触发条件。这是黑板架构比点对点消息更容易扩展的根本原因。
二、一次故障排查,看懂"状态如何推动协作"
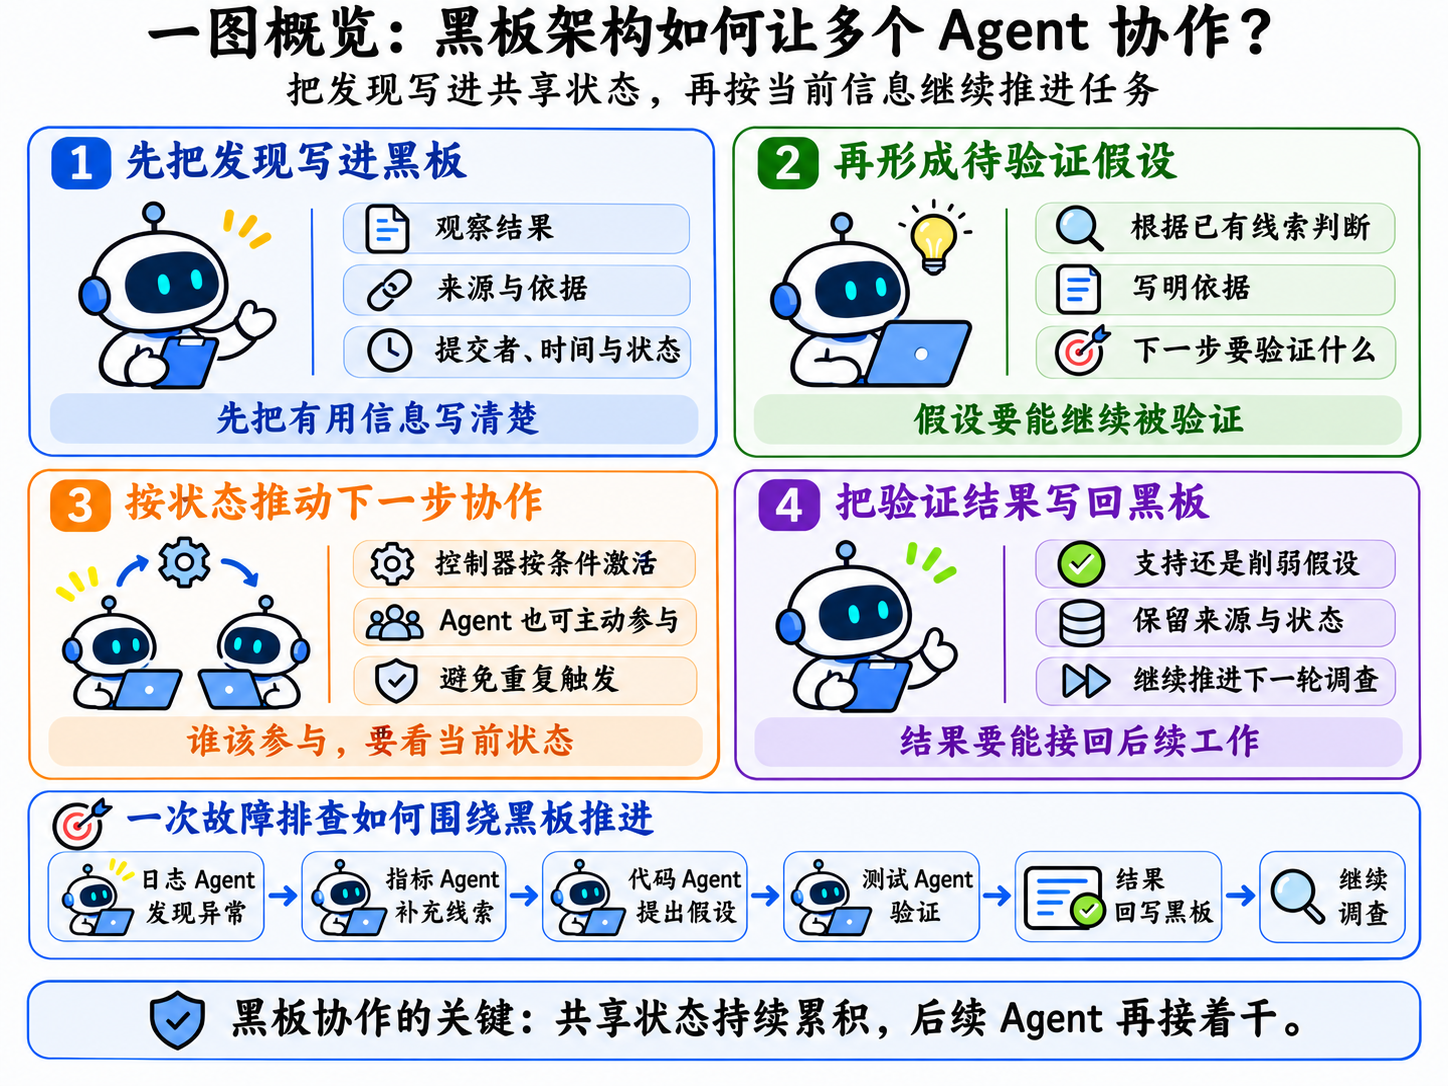
原文给了一个很好的假设性场景(注意:这是用于解释机制的示例,不是真实故障记录)。我把它画成时序图,会更直观:
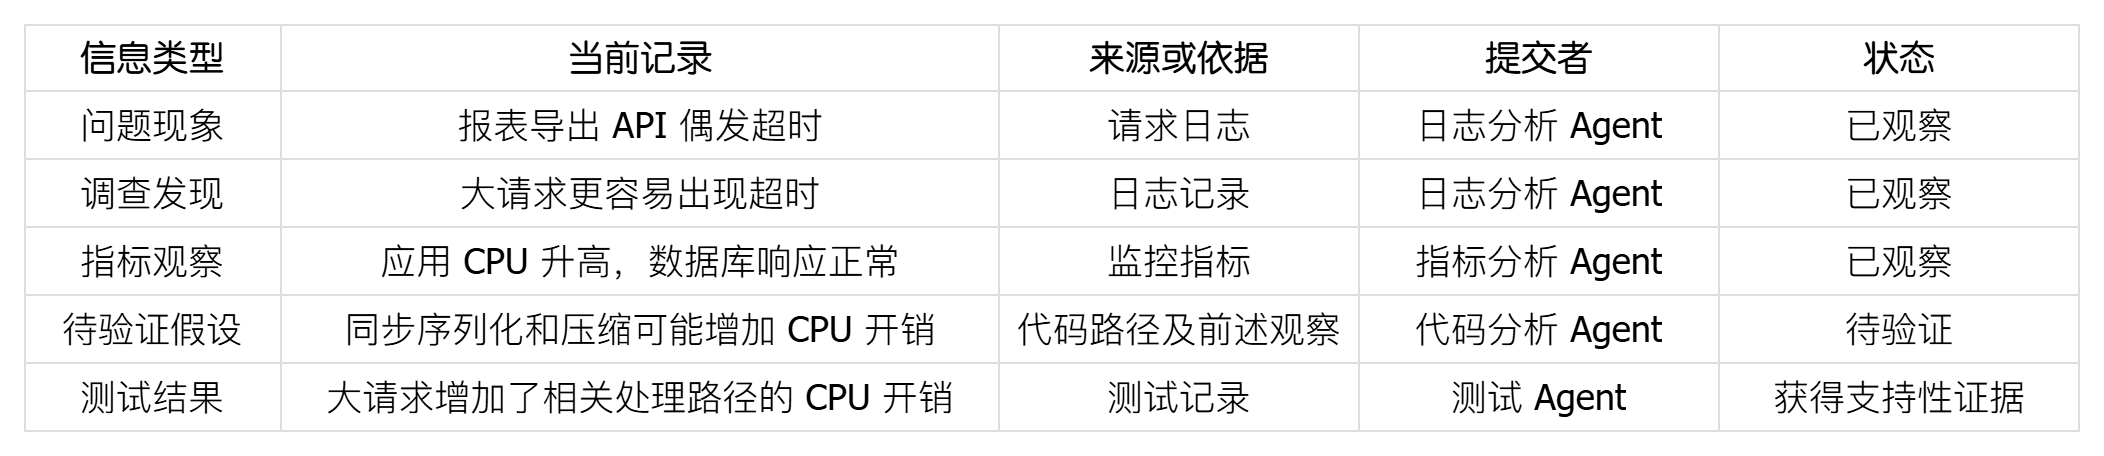
注意黑板上的每条记录,本质都不是一条"消息",而是一次带上下文的状态变更:它记录类型、具体内容、来源依据、提交者、时间和当前状态。所以下一个 Agent 接手时,不必先问"这是谁说的、可不可信、针对哪一轮",可以直接在此基础上继续工作。消息传递解决的是"信息如何送达",黑板解决的是"信息如何沉淀成下一步行动的依据"。
三、我的理解:黑板的价值在"选择性共享",而不是"全部公开"
原文有一处容易被略过,但我认为是整套机制的灵魂:日志分析 Agent 在自己的工作上下文里保留完整日志,只把关键观察和证据引用写入黑板。
为什么这很重要?因为黑板不是"共享内存",也不是"共享文件夹"。它应该是一本认知账本:只记录那些"会影响集体下一步判断"的加工后信息。把原始日志、完整对话历史、所有中间推理都倒进去,不是在增强协作,而是在制造上下文污染——后来的 Agent 会在噪声里迷路。
我在设计一块黑板时,会用三个问题做闸门:
- 这条信息是否被两个以上的参与者需要?
- 它是否会改变别人的下一步动作?
- 它能否给出来源或证据,让别人复核?
三个答案都是否,就留在 Agent 自己的上下文里,不要上黑板。
进一步,黑板上的信息应严格区分三级状态:
- 观察结果:已发生的现象 + 具体证据引用;
- 待验证假设:推测内容 + 支持它的观察 + 下一步要验证什么;
- 阶段性结果:测试条件 + 执行结果 + 该结果支持还是削弱了哪个假设。
这里还有一个我认为特别值得警惕的点。原文提醒:有些实现会记录置信度,但置信度不能代替证据来源和验证状态,也不应仅凭 Agent 自报的置信度判断哪条信息更可靠。我的理解是:在多 Agent 系统里,置信度只是模型的主观感受,证据链才是可复核的客观依据。把一句"我 90% 确定是序列化问题"当成事实写上黑板,后面所有 Agent 都会在这个错误前提上继续推理——个体的幻觉会通过共享状态被整个系统放大。黑板放大正确的观察,也同样放大错误的判断。
四、控制器不是配角:机会式问题求解需要边界
"谁来决定下一个 Agent 什么时候参与?"原文给了两条路:
- 控制器:监控黑板状态,按预设条件激活相应 Agent;
- 机会式问题求解:Agent 自己关注黑板,发现能贡献时主动参与。
原文说两者可以结合。我的理解是:这两条路其实回答的是两个不同的问题——机会式解决"谁来发现新机会",控制器解决"谁有权执行"。前者扩展了系统的感知面,后者保证行动不会失控。
真正落地时,至少要回答四件事:
- 触发条件:什么状态变化值得唤醒一个 Agent?不是每次写入都要广播。
- 幂等去重:测试 Agent 订阅"待验证假设"的变化时,要为记录设置唯一标识或版本号,并记录自己处理过的版本,避免同一条更新反复触发执行。这是原文明确点出的实践。
- 冲突裁决:两个 Agent 对同一问题判断不同,不应让后写入的内容简单覆盖先前记录。保留不同版本及来源,再用证据去验证。
- 终止条件:什么时候停止调查?黑板架构本身的循环并不提供终止判断,需要显式定义"目标已达成"或"没有参与者能继续推进",否则系统可能无限地生成新假设。这是我的工程推论,也是很多自治 Agent 循环容易踩的坑。
五、别把"协作拓扑"和"协调机制"混为一谈
原文里一个很重要的澄清是:黑板描述的是一种协调机制,而 Orchestration(管理者模式)、Peer Collaboration(对等协作)、Decentralized(去中心化)描述的是 Agent 之间的协作拓扑。它们属于不同维度,可以自由组合。很多人把黑板架构和 Manager-Worker 并列成"两种架构",其实是范畴错误。
放在一起比较,边界会更清楚:
| 方式 | 关注点 | 更适合 |
|---|---|---|
| 直接消息传递 | 信息如何送达、路由给谁 | 交接明确、参与方固定 |
| Manager-Worker | 任务如何拆解、依赖如何安排 | 路径已知、步骤可预设 |
| 共享文件系统 | 工作产物如何存放与交换 | 交换报告、代码等成品 |
| 黑板架构 | 共享信息如何推动后续工作 | 路径未知、发现会改写方向 |
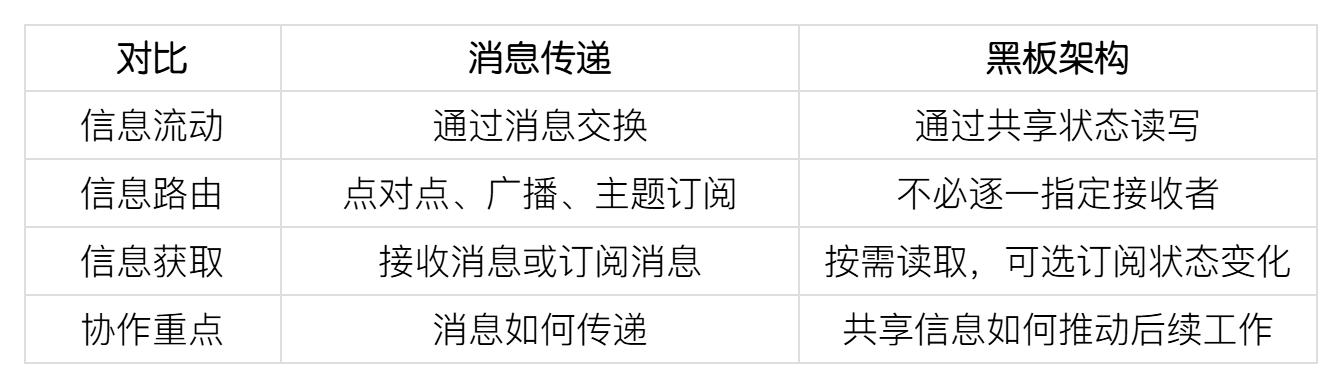
共享文件系统可以成为黑板的实现基础,但"让几个 Agent 读同一批文件"不等于"系统已经具备黑板协调机制"。差别就在于有没有把信息组织成能驱动下一步行动的状态,以及有没有相应的激活与调度规则。
六、什么时候不要用黑板
按原文给出的判断,黑板适合解决路径事先未知、需要不同专业能力、且新发现会改变他人工作的任务:复杂故障排查、科学假设生成、多来源情报分析都在此列。反过来,如果任务简单、步骤明确,或者只是"一个 Agent 把结果交给另一个 Agent",直接消息传递或任务分解就够了。
采用黑板架构要付出四项工程成本,原文总结得很到位:状态维护(区分观察、假设与结论,保留来源与验证状态)、更新协调(版本与历史,避免并发覆盖)、参与控制(合理触发条件,避免重复执行)、访问边界(共享空间不等于所有参与者权限相同)。
用我自己的话说:黑板架构是拿"额外的基础设施成本"换"对不确定性的适应能力"。只有当问题路径的不确定性足够高,这笔交易才划算。它也不承诺信息实时一致,更不保证写入的结论正确——共享只是让信息可用,不让信息天然可信。
结语
黑板架构最深刻的一点,是把"多 Agent 协作"从一个通信问题重新定义成了一个状态问题:与其设计谁给谁发消息,不如设计一份所有人都看得懂、能追溯、可继续加工的问题状态,再让专业能力在合适的时机进来贡献。
原文最后预告的下一期话题——身份确认、访问控制、操作追踪——并不是另起炉灶,而是黑板架构的必然延续:一旦一份状态成为集体行动的依据,就必须回答"谁有资格写、谁为这条记录负责"。 共享状态的价值和风险,来自同一个源头。