把视频变成一门可编译的语言:拆解 Hypit 的语义时间模型与执行架构
一个视频作者最熟悉的地狱时刻是这样的:客户说"把’ hair gel’这个梗出现的时间点往后挪半秒",于是你打开时间轴,找到第 7 秒第 12 帧,拖动一个 B-roll 图层,结果发现字幕、音轨、转场、音效全都要跟着重对齐。改一句话,动十个地方——因为你编辑的是秒,而客户说的是词。
Hypit 想解决的,就是这个错位。它在 GitHub 上以 3 万星的速度蹿红(仓库 hypit-ai/hypit,2026 年 7 月创建,四个月冲到 30,824 星),号称"给 AI Agent 一门做视频的语言"。我扒了它的源码和文档——60 多个 npm 包、一套叫 SVML 的标记语言、一个领域无关的图编译器。看完之后我的判断是:这不是又一个 AI 视频套壳工具,它真正做的事,是把视频制作从"时间轴编辑"重新定义成"语义编译"。
这篇文章我尽量讲清楚三件事:它的核心设计(语义时间)、它的实现架构(编译器内核),以及它到底怎么用、有什么坑。所有技术论断都来自仓库里的源码和官方文档,不是我猜的。
一、它到底解决什么问题:从"秒"到"词"
先把最关键的一句话放在前面:在 Hypit 里,脚本(Script)不写任何时间码。
这是整个设计的地基。看一段官方示例里的真实脚本:
<script id="story">
  <ronaldo>
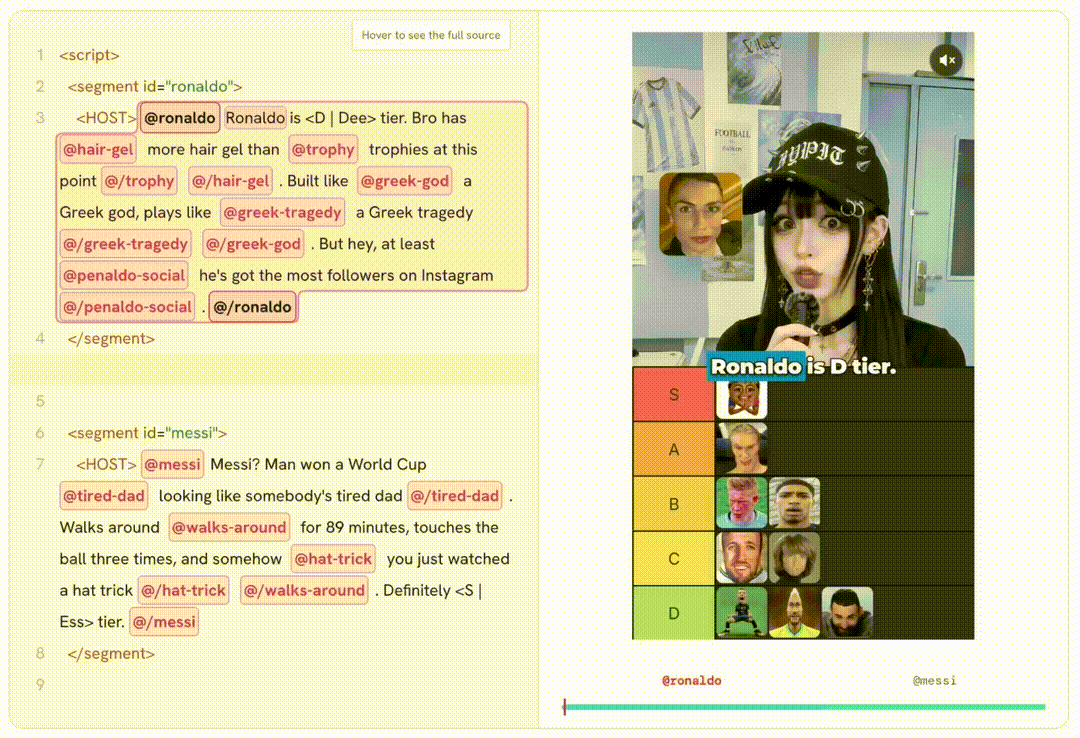
    <HOST>Ronaldo is <D | Dee> tier. || Bro has @{hair-gel} more || hair gel than @{trophy} trophies || at this point.@{/trophy}@{/hair-gel}
  </ronaldo>
</script>
这段代码里有几种东西:
<HOST>是角色提示(Role Cue),标明"谁在说",但它不绑定具体音色、不创建角色实体;<D | Dee>是双文本(Dual Text):左边是屏幕上显示的字幕"D",右边是要念出来的"Dee";||是字幕断句(Caption Cue);@{hair-gel}...@{/hair-gel}是语义选区(Selection)——它圈住"hair gel"这几个词,但不说它对应第几秒。
注意最后这一点。脚本里所有的时间信息都是"相对的、语义的":这个词、这句话、这个笑点。文档里写得很直白:“Script reads nothing”(脚本不读取任何东西)——它是纯粹的源,管道里所有其他部分都读它,它谁都不读。
为什么这么设计?因为视频创作者思考的单位是"内容",不是"帧"。当一个笑点的台词被改写、或者换了个语速的配音,它发生的时间自然会变。如果B-roll、字幕高亮、音效这些事件都锚定在"词"上,那么改一句话,所有关联事件会自动跟着移动——这就是 README 里那句 “anchored to words instead of seconds”(锚定在词上而非秒上)的真实含义。
二、语义时间是怎么算出来的:三层时间架构
这是我认为整个项目最精华、也最值得学习的地方。它把"时间"拆成了三种互不相干、按需组合的东西。我按源码文档还原成下面这张图:
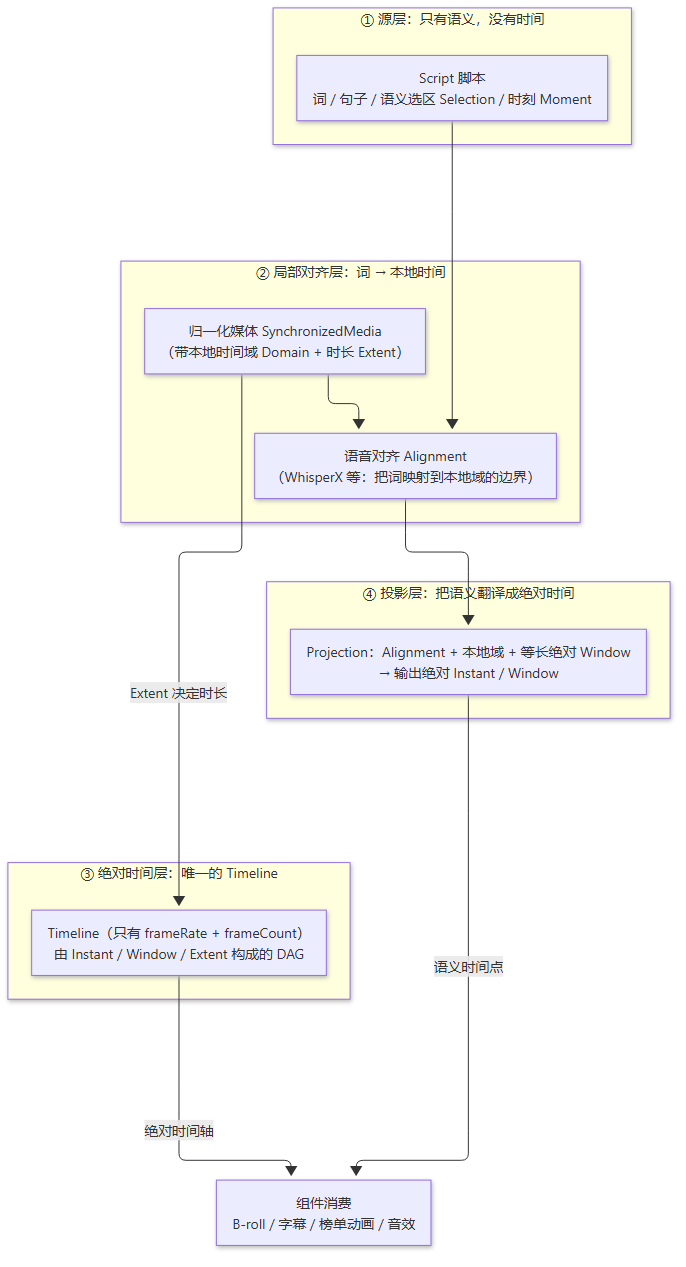
拆开来看这三步(对应官方 timing.md 的实现):
第一步,归一化本地媒体。 每段素材(A-roll 主镜头、B-roll)先被归一化成 SynchronizedMedia,带一个本地时间域(domain)和时长(extent)。这一步纯物理事实,不含任何脚本语义。
第二步,语音对齐。 当需要知道"词在配音里的具体位置"时,才调用 WhisperX 之类的对齐服务,产出 NarrativeAlignment——它只记录"这个词在这段本地音频的第几毫秒",不选择它在最终成片里的位置。
第三步,构建唯一的绝对时间轴。 Timeline 极其克制,只有 { id, frameRate, frameCount } 三个字段,不含任何 clip、词或中央事件表。它由一张命名的时间点/时间窗 DAG 构成:
<time:Timeline id="speech" clock={clock} end="answer.end">
  <time:Window id="opening" from="start" for={opening-media.extent}/>
  <time:Window id="answer" from="opening.end" for={answer-media.extent}/>
</time:Timeline>
这里 for={opening-media.extent} 意味着:生成的语音有多长,时间轴就有多长——时长是在图求值过程中动态产生的,不需要人事先写死。
第四步,语义投影(Projection)。 这是点睛之笔:把第二步的对齐结果 + 本地域 + 第三步里一个等长的绝对窗口配对,就能把脚本里的 @{hair-gel} 翻译成成片里的一个绝对时间窗:
<semantic:Window id="selection-hair-gel" projection={story-time}
                 during={story.selection.hair-gel}/>
然后 B-roll 图层直接消费这个窗口:
<visual:Clip id="hair-gel" image={broll-hair-gel.image}
             extent={hair-gel-extent} during={selection-hair-gel}/>
链路闭合了:词 → 对齐 → 投影 → 绝对时间窗 → 画面出现。中间任何一环变化(改词、换配音、调整段落顺序),后面的时间全部自动重算。
我的理解是,这套设计的本质是一次关注点分离:媒体事实、语义证据、绝对摆放,三种时间各自独立演进,只在消费点显式配对。它带来的直接好处是——改一个东西不会连锁污染其他东西。文档里有句话总结得很到位:“moving a passage changes absolute relationships without changing its media or local word evidence”(移动一个段落只改变绝对关系,不改变它的媒体和本地词证据)。
这套思路如果你做过前端,会觉得眼熟:它很像把 React 的"声明式 + 单向数据流"搬到了视频领域。你描述"什么事件响应什么语义",而不是命令式地一帧帧摆位置。
三、实现架构:一个"领域无关内核" + 一堆可插拔包
看懂了语言,再看工程实现。Hypit 的源码是一个 pnpm monorepo(@hypit/hypit v0.3.3,Node 22.15+),有 60 多个包。但真正的核心只有薄薄三层,而且这三层刻意做到了"不知道自己在做视频"。这个设计选择让我印象很深。
我把它画成一张分层图:
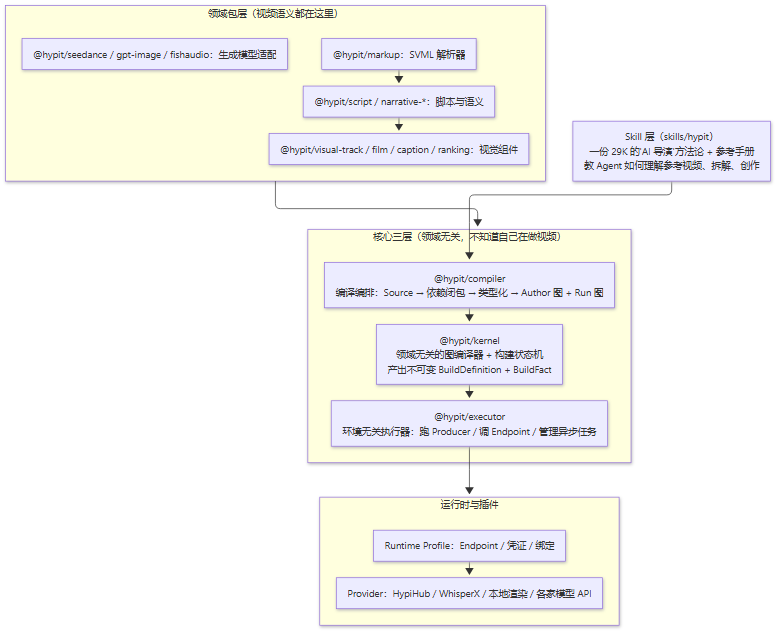
3.1 compiler:两阶段编译 + 双图
@hypit/compiler 的职责是把源码变成执行图。它的流水线是:
ResolvedSource + 已注册的 Frontends + manifests
  → 发现 Source/Module 依赖闭包
  → 类型化的 Source Closure
  → Author Module + Graph
有两个我特别欣赏的设计细节:
两遍解析。 discoverMarkup 第一遍只读根元素和开头的 import 声明(因为必须先知道有哪些导入,才能解码正文);拿到编译器给出的完整闭包后,decodeMarkup 第二遍才解析主体。这是个很典型的编译器设计——先符号表,再语义分析。
Author 图与 Run 图分离。 一份视频作品(Author Source,.svml)描述"做什么",一次运行(Run Source,.svrun)描述"这次选哪些候选、产出什么"。编译器把两张图分别编译,最后绑定成一张不可变图,再交给内核生成有限的 BuildPlan。文档明确说 “The Author Graph remains unchanged”(作者图保持不变)——这意味着同一套作品可以反复跑不同的变体,这正是 README 吹的"一次编写,100 个变体"的技术基础。
还有个安全细节:compiler 把"导入源码"和"读取资源"做成了两种不同权限。一个 import 字符串不会被执行成 npm 代码(“treating an import string as permission to execute npm code would violate the trust boundary”),资源文件也只能通过受限的 resolveAsset() 能力拿到内容寻址的 BlobRef,Surface 永远接触不到文件路径。这种对信任边界的在意,在 AI Agent 生成代码的场景里尤其重要。
3.2 kernel:领域无关的图编译器 + 构建状态机
@hypit/kernel 是整个系统最硬核的部分,但它只有 2K 的文档——因为它的抽象非常克制。它的模型是:
执行 = 一份不可变的
BuildDefinition+ 一串被接受的BuildFact。BuildMachine重建当前视图、发射下一条命令、接受结果。
用 increment build 的思路理解:从 Targets 出发,应用显式满足关系(satisfaction),跟随被选候选引入的所有依赖,推导出一个有限执行闭包。它内部维护 Record/Need/Command 索引、缺失输入计数、反向依赖——所以一个 Fact 提交后,只唤醒输入变化的那些步骤。而且这些索引都可以从 Definition + Facts 完全重建,不需要序列化,是纯粹的"一次性视图"。
文档反复强调它"不解析源文件、不加载包、不执行组件、不调用 provider、不知道什么是视频"。这是典型的内核最小化哲学:把复杂性留在编排层和插件层,内核只做可靠的图调度。见过太多把业务逻辑揉进调度器的项目,这种克制是罕见的。
3.3 executor + Provider:把外部世界接进来
@hypit/executor 负责执行内核发出的命令。它区分两类 Producer 处理器(确定性的组件计算)和 Endpoint(具体的外部能力实现)。异步 endpoint 采用"提交任务 → 存 handle → 轮询 → 可取回产物"的模式,凭证只针对所选 endpoint 声明的槽位解析。
而能力如何映射到具体服务,由 Runtime Profile 配置决定。一个最小的本地处理 Profile 长这样:
{
  "format": "hypit.runtime-local@1",
  "dataRoot": ".hypit/runtimes/local",
  "credentials": {},
  "endpoints": {
    "media.local": { "use": "@hypit/media-local" }
  },
  "bindings": {}
}
这里是理解 Hypit 商业模式的关键:模型(Model)定义"请求什么",Provider 负责"用哪个服务执行、怎么定价"。HypiHub 是官方推荐的托管服务,但你也可以接自己的 API 或本地模型——只要写个 Provider 告诉 Agent 服务名和 API 文档即可。文档里有句话很实在:“A failed service request does not silently select another account”(失败的请求不会偷偷换另一个账号)——这种对确定性行为的坚持,和前面语义时间的设计是一脉相承的。
Provider 生态已经相当庞大:provider-hypihub、provider-whisperx-local、provider-html-local、provider-image-opencv-local,以及 sume、monid、pollo、beatapi、hiapi、tokendance 等第三方。生成模型侧则适配了 Seedance、GPT Image、Fish Audio、ElevenLabs、MiniMax、Pika/Pixverse、Grok Imagine 等一长串。
3.4 Skill:那个 29K 的"AI 导演手册"
前面三层都是工程,但 hypit 真正让 Agent 能"自动拆解复刻视频"的,是 skills/hypit/SKILL.md——一份 29KB 的提示词手册。它不是简单说"调用这些工具",而是把视频导演的隐性知识写成了 Agent 可执行的判断框架:
- 它要求 Agent 先"理解整体":看参考视频、抽帧、按时间读字幕,找出"它为什么抓人";
- 它引入了 Brief(用户目标)、Treatment(创意答案)、Analysis(整体解读)、Timeline(带时间的细节)、Progress(当前进度)等项目文件作为"记忆",明确写着 “Files are the memory”;
- 它把创意决策工程化:“保留每个事件响应的东西”(preserve what each event responds to)——也就是复刻时,变的是内容,不变的是"什么触发什么"的结构关系;
- 它甚至有大量"软约束":钱(付费前先确认计费账户和预算)、凭证、证据(“把你看到的和你对它的解读分开写”)、完成标准(“Done means watched”——必须真的看完成片才算完成)。
这部分给我的触动最大。它印证了一个趋势:Agent 的能力上限,越来越取决于你能否把领域专家的隐性判断,翻译成结构化、可执行的上下文。这和 VeKnow 的"工作上下文"、研发数字人的"判断力结构化"是同一个时代命题——只不过 Hypit 把它用在了视频导演这个领域。
四、如何使用:两种入口
入口 A:让 Agent 帮你做(推荐)
安装 Skill 只需要一条命令:
npx skills add hypit-ai/hypit -g
然后在任意项目目录里对编码 Agent(Claude Code、Codex 等)说:
/hypit 复刻这个视频:/path/to/video.mp4,把榜单内容换成 Hypit 与其他 AI 视频产品的对比
或者不提供参考视频,直接描述:
/hypit 做一个把 Hypit 排在 S 级的榜单视频
Agent 会自己检查环境、请求所需凭证、生成素材、组装并构建成片。第一次使用时它会检查 Hypit 可执行文件并帮你准备。注意:Hypit 本体免费,但编码 Agent 的额度和你选的模型服务是另行计费的。
入口 B:手写 SVML(理解原理 / 精细控制)
一个最小项目包含三个文件:
.svml(作品源码)——用<import>引入需要的组件包,然后声明脚本、素材、时间轴、轨道;.svrun(运行源码)——指定这次用哪个作品、要哪个产物:
<?svml using="@hypit/markup/run@1"?>
<svrun version="1">
  <author source="./main.svml"/>
  <target output="final.video"/>
</svrun>
hypit.runtime.json(运行时配置)——选择端点和凭证。
然后用 CLI 走标准构建流程:
hypit runtime init              # 生成可编辑的运行时配置
hypit runtime up --endpoint media.local   # 准备本地媒体处理服务
hypit check reference.svml      # 检查源码
hypit plan build.svrun          # 预览计划(哪些请求、多少成本)
hypit pricing build.svrun       # 查看价格
hypit build build.svrun --follow  # 提交构建并跟随
hypit status <build-id> --watch  # 观察状态
hypit get <build-id> --to output/final.mp4  # 导出成片
有个细节很实用:build 由独立的 Worker 执行,关掉 --follow 的终端不会取消构建;失败后可以保留已完成的产物,在新的 Run 里显式复用,不必从头再来。官方声称一个 20 秒的视频,64 路无头 Chromium 并行渲染,成本约 1.07–1.15 美元(这是官方示例的说法,我无法独立复现账单,仅作参考)。
五、冷静一点:三个必须说清楚的问题
技术问题我一向主张"先看它吹什么,再看它没说什么"。这里有三点我的判断。
第一,许可证不是标准 Apache 2.0,有商业限制。 这是最容易被"开源"两个字误导的地方。它的 LICENSE 是"修改版 Apache 2.0":允许你自己或你的组织内部商用(包括作为自己应用的渲染后端、给客户做商业项目、单租户部署),但明确禁止两类行为——未经书面授权运营多租户服务(把 Hypit 包装成 SaaS 卖给第三方)、以及商业再分发。改了源码的 fork 可以发布,但必须用同一许可证且不得商业获利,还不能使用其商业名称、Logo 和版权信息。所以"开源免费"的正确理解是:自己用免费,拿它做生意要谈授权。想把它集成进自己的 SaaS 产品,先读 LICENSE 或联系官方。
第二,它是 0.3.3 版本,仍然年轻。 从 7 月创建到现在四个月,版本号还在 0.x。文档里能看到 0.3 的迁移指南(含 0.3.1 的 SDK import 变更),说明接口还在快速演进。现在基于它做深度二次开发,要有"跟着升级改代码"的心理准备。另外,仓库有 127 个开放 issue——活跃是好事,但也说明边界情况还不少。
第三,"AI 自动拆解"的上限取决于参考视频的可读性。 Skill 手册里反复要求 Agent 抽帧、按时间读字幕、找出"笑点响应什么语义"。对于表演驱动、对白清晰的视频,这套方法很有效(官方给的 UGC、播客、街采都是这类)。但对于高度依赖视觉隐喻、无对白、或者靠复杂运镜叙事的内容,"把事件锚定到词"这个核心假设会失效——词都没有,锚什么?文档里虽然提到纯动画可以用秒和帧直接声明,但那已经偏离了它最强的生产范式。这不是缺点,而是设计取舍:它选择了"语义驱动"这条路,就必然在时间轴叙事类内容上没那么顺手。
六、写在最后:它其实是一份"编译器思维"的宣言
我一开始以为这是个 AI 视频生成工具,看完源码发现我错了。生成模型在 Hypit 里只是可替换的 Provider——你可以用 Seedance、GPT Image,也可以完全不调用任何生成服务,纯靠代码渲染出成片。真正不可替代的,是那套把创作意图编译成可执行、可复现、可变异的作品结构的能力。
这和最近我连续拆解的几个系统形成了一种呼应:研发数字人把判断力结构化,VeKnow 把工作上下文沉淀成数据形态,淘宝 OntSQL 把业务知识编译成可验证的规则。它们都在回答同一个问题——当 AI 开始替人做判断,工程的回应不是给它更大的自由度,而是给它更清晰的结构、边界和证据链。Hypit 的答案是:把视频制作变成一门语言,让编译器而不是时间轴,去处理那些脆弱的对应关系。
从这个角度看,@{hair-gel} 这样小小的语义标记,不只是一个语法糖。它是把"人的意图"和"机器的执行"之间那条最容易断的线,用代码重新缝了一遍。