XXL-AI 深度解析:从源码读懂「云本结合」的 AI Agent 开发平台
XXL-AI 深度解析:从源码读懂「云本结合」的 AI Agent 开发平台
阅读地图:第一~三章讲定位与工程架构;第四章是全文核心,逐个拆解云版八大运行时机制;第五章拆本地版三进程架构;第六~八章是设计思路、优点与代码级局限;第九章是竞品对比;第十~十二章是可直接照做的上手教程、二开指南与选型建议。
一、它到底是什么:一段历史,两种形态
1.1 血统:一个 Java 中间件作者切入 AI 平台的方式
作者许雪里(xuxueli)是 XXL 系列开源中间件的维护者——XXL-JOB(分布式任务调度)、XXL-SSO、XXL-CONF、XXL-RPC、XXL-MQ、XXL-BOOT。这条背景很重要,因为它几乎决定了 XXL-AI 的全部气质:它不是从"提示词编排"长出来的产品,而是从"中后台工程底座"长出来的产品。
项目沿革写得很直白:
- 2026 年 6 月:把 XXL-BOOT 里的 AI 插件模块拆出来,升级为独立的 AI 应用开发平台 XXL-AI;
- 2026 年 9 月 27 日:发布 v1.0.0,一次性交付 Agent 编排、RAG、MCP、SKILL、一键发布、流式对话;
- 2026 年 11 月 8 日:发布 v1.5.0。
也就是说,从 v1.0.0 到 v1.5.0 只用了 6 周、8 个版本,平均每 5~7 天一个版本。看版本日志能清楚看到能力叠加的节奏:v1.1.0 上桌面客户端与进程隔离,v1.2.0 上云版长期记忆与会话模块重构,v1.3.0 把 SKILL / MCP / 浏览器工具搬进桌面端,v1.4.0 补人机交互、Agent 可观测、Git 工具,v1.5.0 做会话压缩、长期记忆与扩展中心重构,并新增应用中心与笔记应用。
1.2 「云本结合」不是"云端同步到本地"
这是最容易误读的一点。XXL-AI 的两种形态同源同品牌、但代码与数据完全独立、互不依赖:
| 维度 | 云版(Web 服务端) | 本地版(Desk 桌面端) |
|---|---|---|
| 仓库模块 | xxl-ai-api + xxl-ai-ui + xxl-ai-sample |
xxl-ai-desk(独立 npm 工程) |
| 形态 | B/S,浏览器访问,可集群 | C/S,Electron 安装包(mac / win / linux) |
| 面向 | 团队,多用户 + 多业务空间(Tenant) | 个人,单机本地工作台 |
| 核心命题 | 资源编排 + 一键发布 + 权限治理 | 本地优先,直接操作本机工程 |
| AI 运行时 | spring-ai ChatClient + Redis Stream worker |
Pi(pi-agent-core/pi-ai)+ 独立 utilityProcess |
| 存储 | MySQL + Redis + Milvus | 单个 SQLite 文件,零服务依赖 |
| 权限边界 | 空间归属 + RBAC + 审计日志 | 三档权限 + 路径闸门 + 敏感操作拦截 |
官方文档明确写:本地版"不连 api / ui / sample 及其 MySQL / Redis / Milvus"。两版不共享数据库、不共享登录态、不共享 Agent 定义,只是共用品牌、共用 MCP / SKILL / OpenAI 兼容协议这些开放规范。这其实是一种很克制的设计:与其做一个"云桌同步"的复杂分布式一致性问题,不如做两个各自闭环的产品。
1.2.1 官方给出的能力对照(据官方教程补充)
README 的简表之外,官方文档第 4 章给了一张更细的对照,这里保留对理解设计取舍最有用的几行:
| 能力维度 | 云版(Web 服务端) | 本地版(Desk 桌面端) |
|---|---|---|
| Agent 编排与发布 | 模型 + 系统指令 + 知识库 + MCP + SKILL 组合,一键生成免登录公开地址,管理端可回看访客会话 | 扩展中心按 Agent 配置指令 / SKILL / MCP / 内置工具,会话创建即绑定 Agent,运行时实时装配 |
| 多模型供应商 | 供应商 + 模型两级、连通测试、远程模型自动导入、区分对话/嵌入模型 | 供应商 + 模型本地配置,首次启动预置四家,支持 {session} 请求头与模型上下文窗口 |
| 流式对话 | SSE + Redis Stream 无状态化,集群部署与断线/刷新续传 | 主进程 / 运行时进程 IPC 事件流,思考 → 工具 → 正文按发生顺序时间线渲染 |
| RAG 知识库 | 知识库 + 文档管理,分片向量化入 Milvus,对话自动检索注入 | 不提供 |
| 本地系统能力 | 不直接操作本机文件 / 终端 / 浏览器 | 核心差异:文件读写检索、终端(node-pty + xterm)、Git 审核、统一工具面板 |
| 读写安全控制 | 空间归属 + RBAC + 审计日志 | 三档权限模式 + 路径闸门 + 敏感操作统一拦截 |
| 登录与权限 | XXL-SSO(Redis 登录态)+ RBAC 菜单/按钮 + 动态菜单 | 无登录、无角色体系,纯本地应用 |
| 数据存储 | MySQL + Redis + Milvus | 单文件 SQLite,零服务依赖 |
官方文档把两版差异归纳为五点:① 架构定位(平台 vs 客户端)、② 数据与部署(三件套可集群 vs 单 SQLite 离线)、③ 运行时(spring-ai ChatClient + Redis Stream worker vs Pi utilityProcess)、④ 能力侧重(资源编排/发布/治理 vs 直接操作本机工程)、⑤ 安全控制(空间 + RBAC + 审计 vs 三档权限 + 路径闸门)。
官方给的组合建议:团队用云版做统一平台与对外发布,个人用 Desk 做本地编码工作台;两版各自独立、互不依赖,可分别安装使用。
1.3 规模与许可证
仓库共 965 个受版本控制的文件,代码规模如下:
| 模块 | 文件数 | 代码行数 |
|---|---|---|
后端 Java(xxl-ai-api + xxl-ai-sample) |
178 个 .java + 18 个 Mapper XML |
18,616 行 |
云版前端 xxl-ai-ui/src |
235 | 24,670 行 |
本地版 xxl-ai-desk/src |
460(TS 326 + Vue 106 等) | 53,171 行 |
一个值得注意的信号:桌面端的代码量是服务端的近 3 倍。这佐证了 v1.1.0 之后项目重心明显向 Desk 倾斜——版本日志里 v1.3.0、v1.4.0、v1.5.0 的绝大多数条目都标注「Desk 版」。
许可证是 GPLv3(LICENSE 35,815 字节),README 明确"个人或企业内部可自由接入和使用",没有 Dify / FastGPT 那种附加商业条款,这一点在第九章会展开。
二、工程架构:Monorepo 与「开发分离、部署合并」
2.1 仓库骨架
xxl-ai/
├── pom.xml                          # Maven 父工程,集中锁定全部依赖版本
├── AGENTS.md                        # 开发规范(DRY/KISS、中文注释、精确版本、i18n)
├── .agents/skills/
│   ├── xxl-ai/SKILL.md              # 云版开发 Skill(324 行)
│   └── xxl-ai-desk/SKILL.md         # Desk 开发 Skill(565 行)
├── doc/db/tables_xxl_ai.sql         # 建库 + 17 张表 + 种子数据,单文件 421 行
├── doc/XXL-AI官方文档.md             # 完整官方文档(1794 行)
├── docker/                          # compose 一键部署栈
├── xxl-ai-api/                      # SpringBoot 后端,:8080
│   └── src/main/java/com/xxl/ai/api/
│       ├── framework/               # 平台内置:登录鉴权、RBAC、系统管理、审计日志
│       └── business/                # 业务:space/supplier/knowledge/mcp/skill/agent/session/chat/memory
│           └── harness/             # 运行时支撑:llm/chat/rag/mcp/skill/memory/supplier
├── xxl-ai-ui/                       # Vue3 前端,开发 :3000
├── xxl-ai-sample/                   # 示例 MCP Server,:8091
└── xxl-ai-desk/                     # Electron 桌面端,独立 npm 工程
2.2 精确锁定的技术栈
根 pom.xml 的 dependencyManagement 把版本号写死,package.json 同样精确版本、禁止 ^ / ~:
| 层次 | 选型 | 版本 |
|---|---|---|
| 运行时 | JDK | 17+ |
| 后端 | Spring Boot | 4.1.2 |
| ORM | MyBatis Spring Boot Starter | 4.1.0 |
| AI 框架 | Spring AI | 2.0.2 |
| 技能工具 | org.springaicommunity:spring-ai-agent-utils |
0.13.0 |
| MCP 客户端 | 官方 Java MCP SDK io.modelcontextprotocol.sdk:mcp |
2.1.0 |
| 向量库 | milvus-sdk-java |
3.0.12 |
| 登录 | XXL-SSO Core | 2.4.1 |
| 云版前端 | Vue 3.5.45 / Vite 8.3.6 / TypeScript 6.0.3 / Element Plus 2.14.8 | — |
| 桌面端 | Electron 45.2.3 / electron-vite 6 / Vue 3 / Pi 1.5.0 | — |
| 桌面存储 | better-sqlite3 13.0.3 + Drizzle ORM 0.45.4 | — |
| 终端 | node-pty 1.1.0 + xterm 6.0.0 | — |
Docker Compose 栈包含镜像:MySQL 8.4、Redis 8.2、Milvus v3.0.2(配套 etcd v3.5.25、MinIO、Attu v3.0.1)、xxl-ai-api、xxl-ai-sample。注意 compose 里 Milvus 是独立一组三容器,不是可选项被裁掉——xxl-ai-api 的 depends_on 只等 MySQL 和 Redis,Milvus 挂了不影响主服务启动,RAG 会在装配时降级(见 4.4)。
2.3 三种运行态,一套代码
开发态:后端 8080、前端 3000,VITE_APP_BASE_API='/api',Vite 代理剥离 /api 后转发。
生产态:npm run build → npm run sync:dist(scripts/sync-dist.mjs 把 dist 复制进 xxl-ai-api 的 classpath:/static/)→ mvn clean package → java -jar,单包、单进程、单端口 8080,页面与接口同源。
这个"单包"能成立的关键细节是 Hash 路由:前端用 /#/xxx,hash 段不发送到服务端,因此不需要 Nginx 的 History 回退配置。这是典型的"为运维简单性牺牲一点 URL 美观"的取舍,也说明作者很懂中小企业真实部署环境。
# 最小开发启动
cd xxl-ai-api && mvn spring-boot:run                 # 8080
cd xxl-ai-ui  && npm i && npm run dev                # 3000

# 生产单包
cd xxl-ai-ui && npm i && npm run build && npm run sync:dist && cd ..
mvn clean package -Dmaven.test.skip=true
java -jar xxl-ai-api/target/xxl-ai-api-*.jar

# 或 Compose 全栈
cd docker && docker compose up -d --build
坑位:compose 里
xxl-ai-api/xxl-ai-sample的 Dockerfile 都是ADD target/*.jar,所以必须先mvn clean package打包两个模块再docker compose up -d。只跑-pl xxl-ai-api会让 sample 镜像报lstat .../target: no such file。这条写进了仓库自带的开发 Skill 里。
三、云版总体设计:六层架构与 harness 分层的意义
3.1 六层全景
┌──────────────────────────────────────────────────────────────────┐
│ 入口层   管理端 admin(登录) · 公开端访客 /#/chat/{uuid}(免登录)│
├──────────────────────────────────────────────────────────────────┤
│ 前端层   xxl-ai-ui:Vue3 + Vite + Element Plus + TS,Hash 路由     │
├──────────────────────────────────────────────────────────────────┤
│ 应用层   xxl-ai-api :8080                                         │
│          framework:登录鉴权 / RBAC / 系统管理 / 审计日志           │
│          business :space / supplier / knowledge / mcp / skill /   │
│                     agent / session / chat / memory               │
├──────────────────────────────────────────────────────────────────┤
│ 运行时层 business/harness:**无 Controller**                       │
│          llm · chat · rag · mcp · skill · memory · supplier        │
├──────────────────────────────────────────────────────────────────┤
│ 支撑层   MySQL(业务) · Redis(登录态 + 对话流) · Milvus(向量)  │
├──────────────────────────────────────────────────────────────────┤
│ 外部层   OpenAI 兼容供应商 · 远程/本地 MCP 服务 · xxl-ai-sample     │
└──────────────────────────────────────────────────────────────────┘
3.2 business / harness:整个项目最值得学的一条边界
XXL-AI 把"业务编排"和"运行时能力"切成了两个世界:
| 层 | 职责 | 硬边界 |
|---|---|---|
business/{module} |
校验、空间归属、状态回写、DTO 组装、全部对外入口 | 自带 Controller,路径 /{module} |
business/harness |
模型构建、对话执行、Redis Stream、MCP、RAG、技能沙箱、供应商探测 | 不定义任何 @RestController、不校验空间归属、不新增元数据表 |
仓库自带 Skill 里给了一句判定口诀:
是业务编排(校验归属、读写业务状态、组装返回)→
business/{module}的 Service;只是它调用的底层能力(HTTP、SDK、模型、向量库、进程沙箱、SSE/队列)→harness。
禁止项写得很死:business/{module} 不得新增 client/rag/tool/stream 运行时子包,不得直接依赖 spring-ai / Milvus / MCP SDK / Redis;harness 不得新增 Controller 与元数据表。允许"反向读元数据"——harness 可以按 ID 经 business 的 Mapper 读配置,但 CRUD 不许挪进 harness。唯一例外记录在案:ChatStreamTool 按 agentId 复校 Agent 并回填消息,属对话域运行时的既定行为。
为什么这条边界值钱:它让"换模型 SDK、换向量库、换传输协议"这些高变动部分被关在一个没有 HTTP 入口、没有业务状态的层里;而 Agent、知识库、MCP 这些 CRUD 页面可以稳定迭代。这也是后面所有机制能被独立讲清楚的前提。
3.3 三条设计主线
- 分层解耦:入口 / 前端 / 应用 / 运行时 / 支撑 / 外部单向依赖,上层不绕过下层;
- 开发分离、部署合并:开发期两个进程独立迭代,部署期一个 jar;
- 生成与传输解耦:请求节点只做"校验落库 + 转发",LLM 生成交给 Redis Stream worker,这是第四章的重点。
四、云版核心机制逐层拆解
4.1 Agent:一行数据库记录就是一次编排
xxl_ai_agent 表把"Agent"这件事做得极其朴素:
CREATE TABLE `xxl_ai_agent` (
  `space_id`          BIGINT        NOT NULL COMMENT '空间ID',
  `name`              VARCHAR(100)  NOT NULL,
  `model_supplier_id` BIGINT        NOT NULL DEFAULT 0,
  `model_id`          BIGINT        NOT NULL DEFAULT 0,
  `system_prompt`     TEXT          NULL,
  `kb_ids`            VARCHAR(500)  NULL COMMENT '知识库ID集合(逗号分隔)',
  `mcp_ids`           VARCHAR(500)  NULL COMMENT 'MCP ID集合(逗号分隔)',
  `skill_ids`         VARCHAR(500)  NULL COMMENT 'Skill ID集合(逗号分隔)',
  `memory_status`     TINYINT       NOT NULL DEFAULT 0 COMMENT '0-关闭、1-开启',
  `publish_status`    TINYINT       NOT NULL DEFAULT 0 COMMENT '0-未发布、1-已发布',
  `uuid`              VARCHAR(32)   NULL,
  UNIQUE KEY `i_uuid` (`uuid`)
)
一个 Agent = 模型 + 系统指令 + 三类多选绑定 ID 串 + 两个开关 + 一个发布 UUID,没有工作流图、没有节点、没有 DSL。多选绑定直接用逗号分隔字符串(splitIds() 在各处重复出现),运行时 ChatStreamTool.buildAdvisors() / buildTools() 逐个解析装配。
取舍评价:✓ 极简,新增绑定零 DDL 变更,一次
load(agentId)就能拿到全部配置;✗ 没有外键、没有关联表,VARCHAR(500)是硬上限,删除知识库 / MCP / 技能时得靠应用层清理残留 ID。这符合项目AGENTS.md里"KISS 优先、禁止为假想需求预留扩展点"的取向,但团队做重治理时要心里有数。
一键发布的本质:publish_status=1 + 生成 uuid,公开端路径 /#/chat/{uuid},ChatController 四个接口全部标 @XxlSso(login = false) 免登录。访客用 visitorId 区分,会话表 xxl_ai_session 以 (agent_id, visitor_id) 建索引;管理端仍按空间与菜单权限回看访客消息。
官方教程补充了几个界面层的约束:Agent 列表直接展示模型供应商、发布状态与访问 URL;编辑弹窗里对话模型是必选项,知识库 / MCP / Skill 三类均可多选绑定;未发布或停用的 Agent 一律不可公开访问。发布后点击「前往 Agent」即可进入免登录对话页,支持新建对话与历史会话切换。
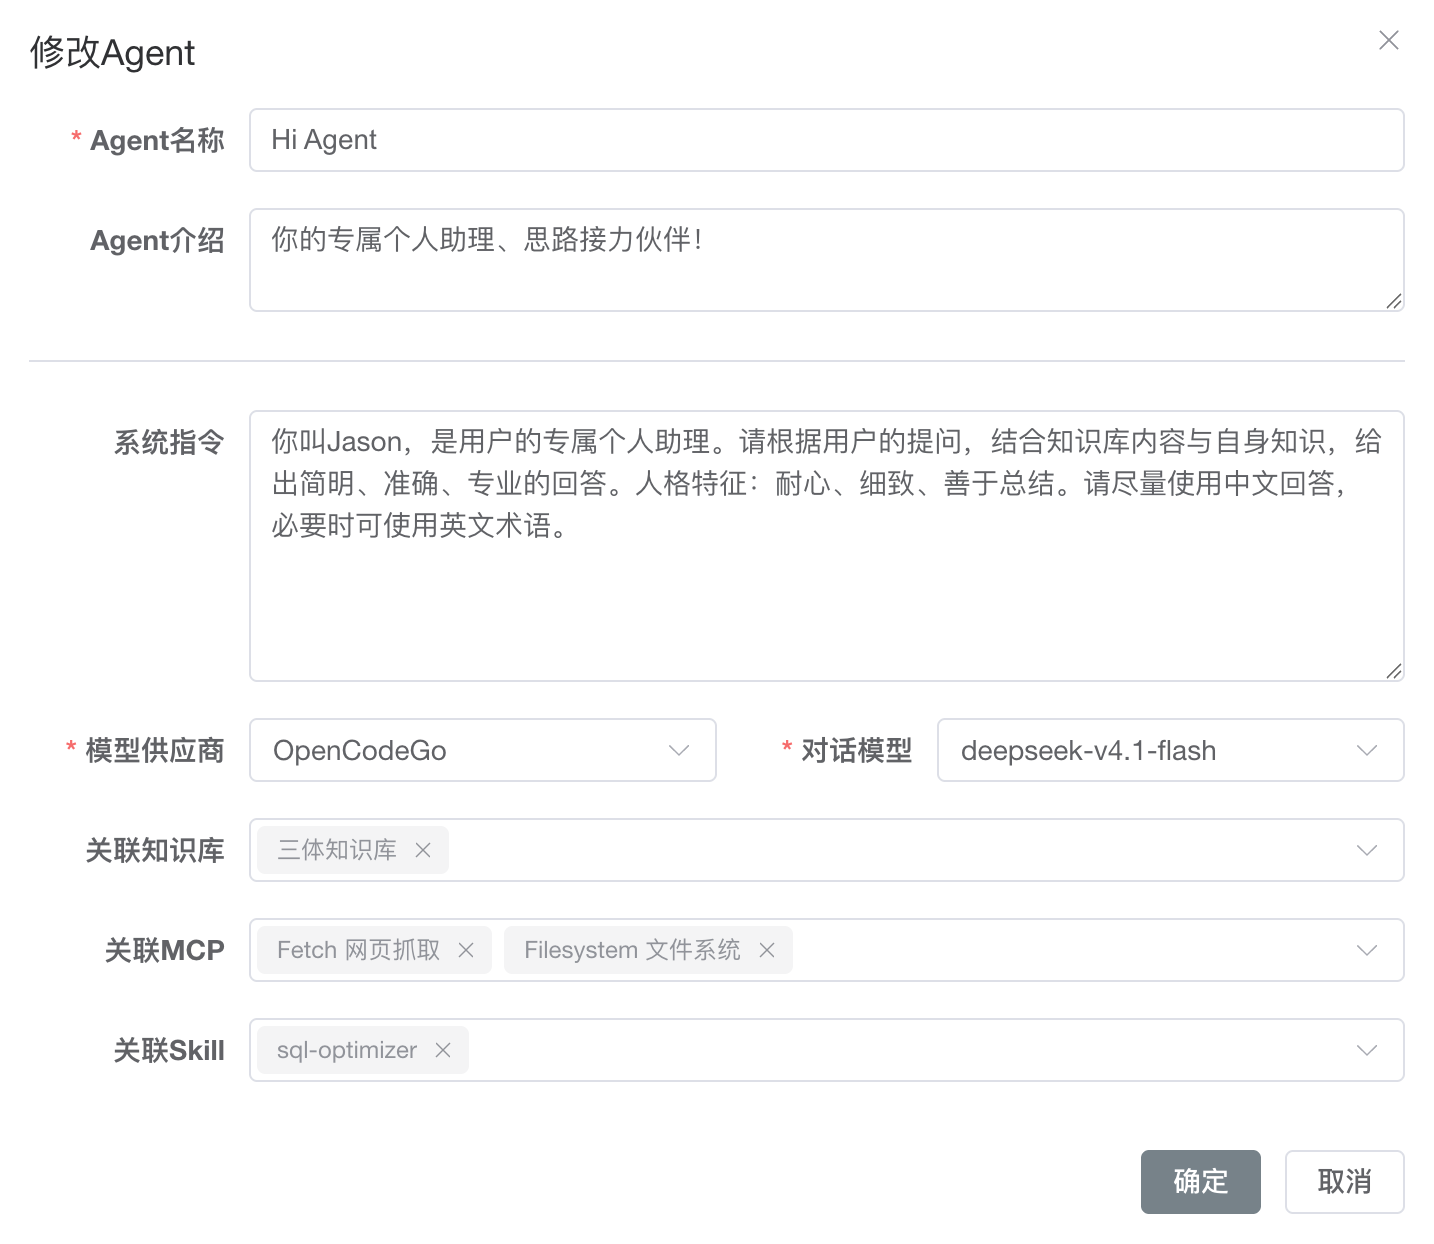
图:Agent 编排界面:系统指令 + 对话模型 + 知识库 / MCP / SKILL 多选绑定(图片来源:XXL-AI 官方文档)
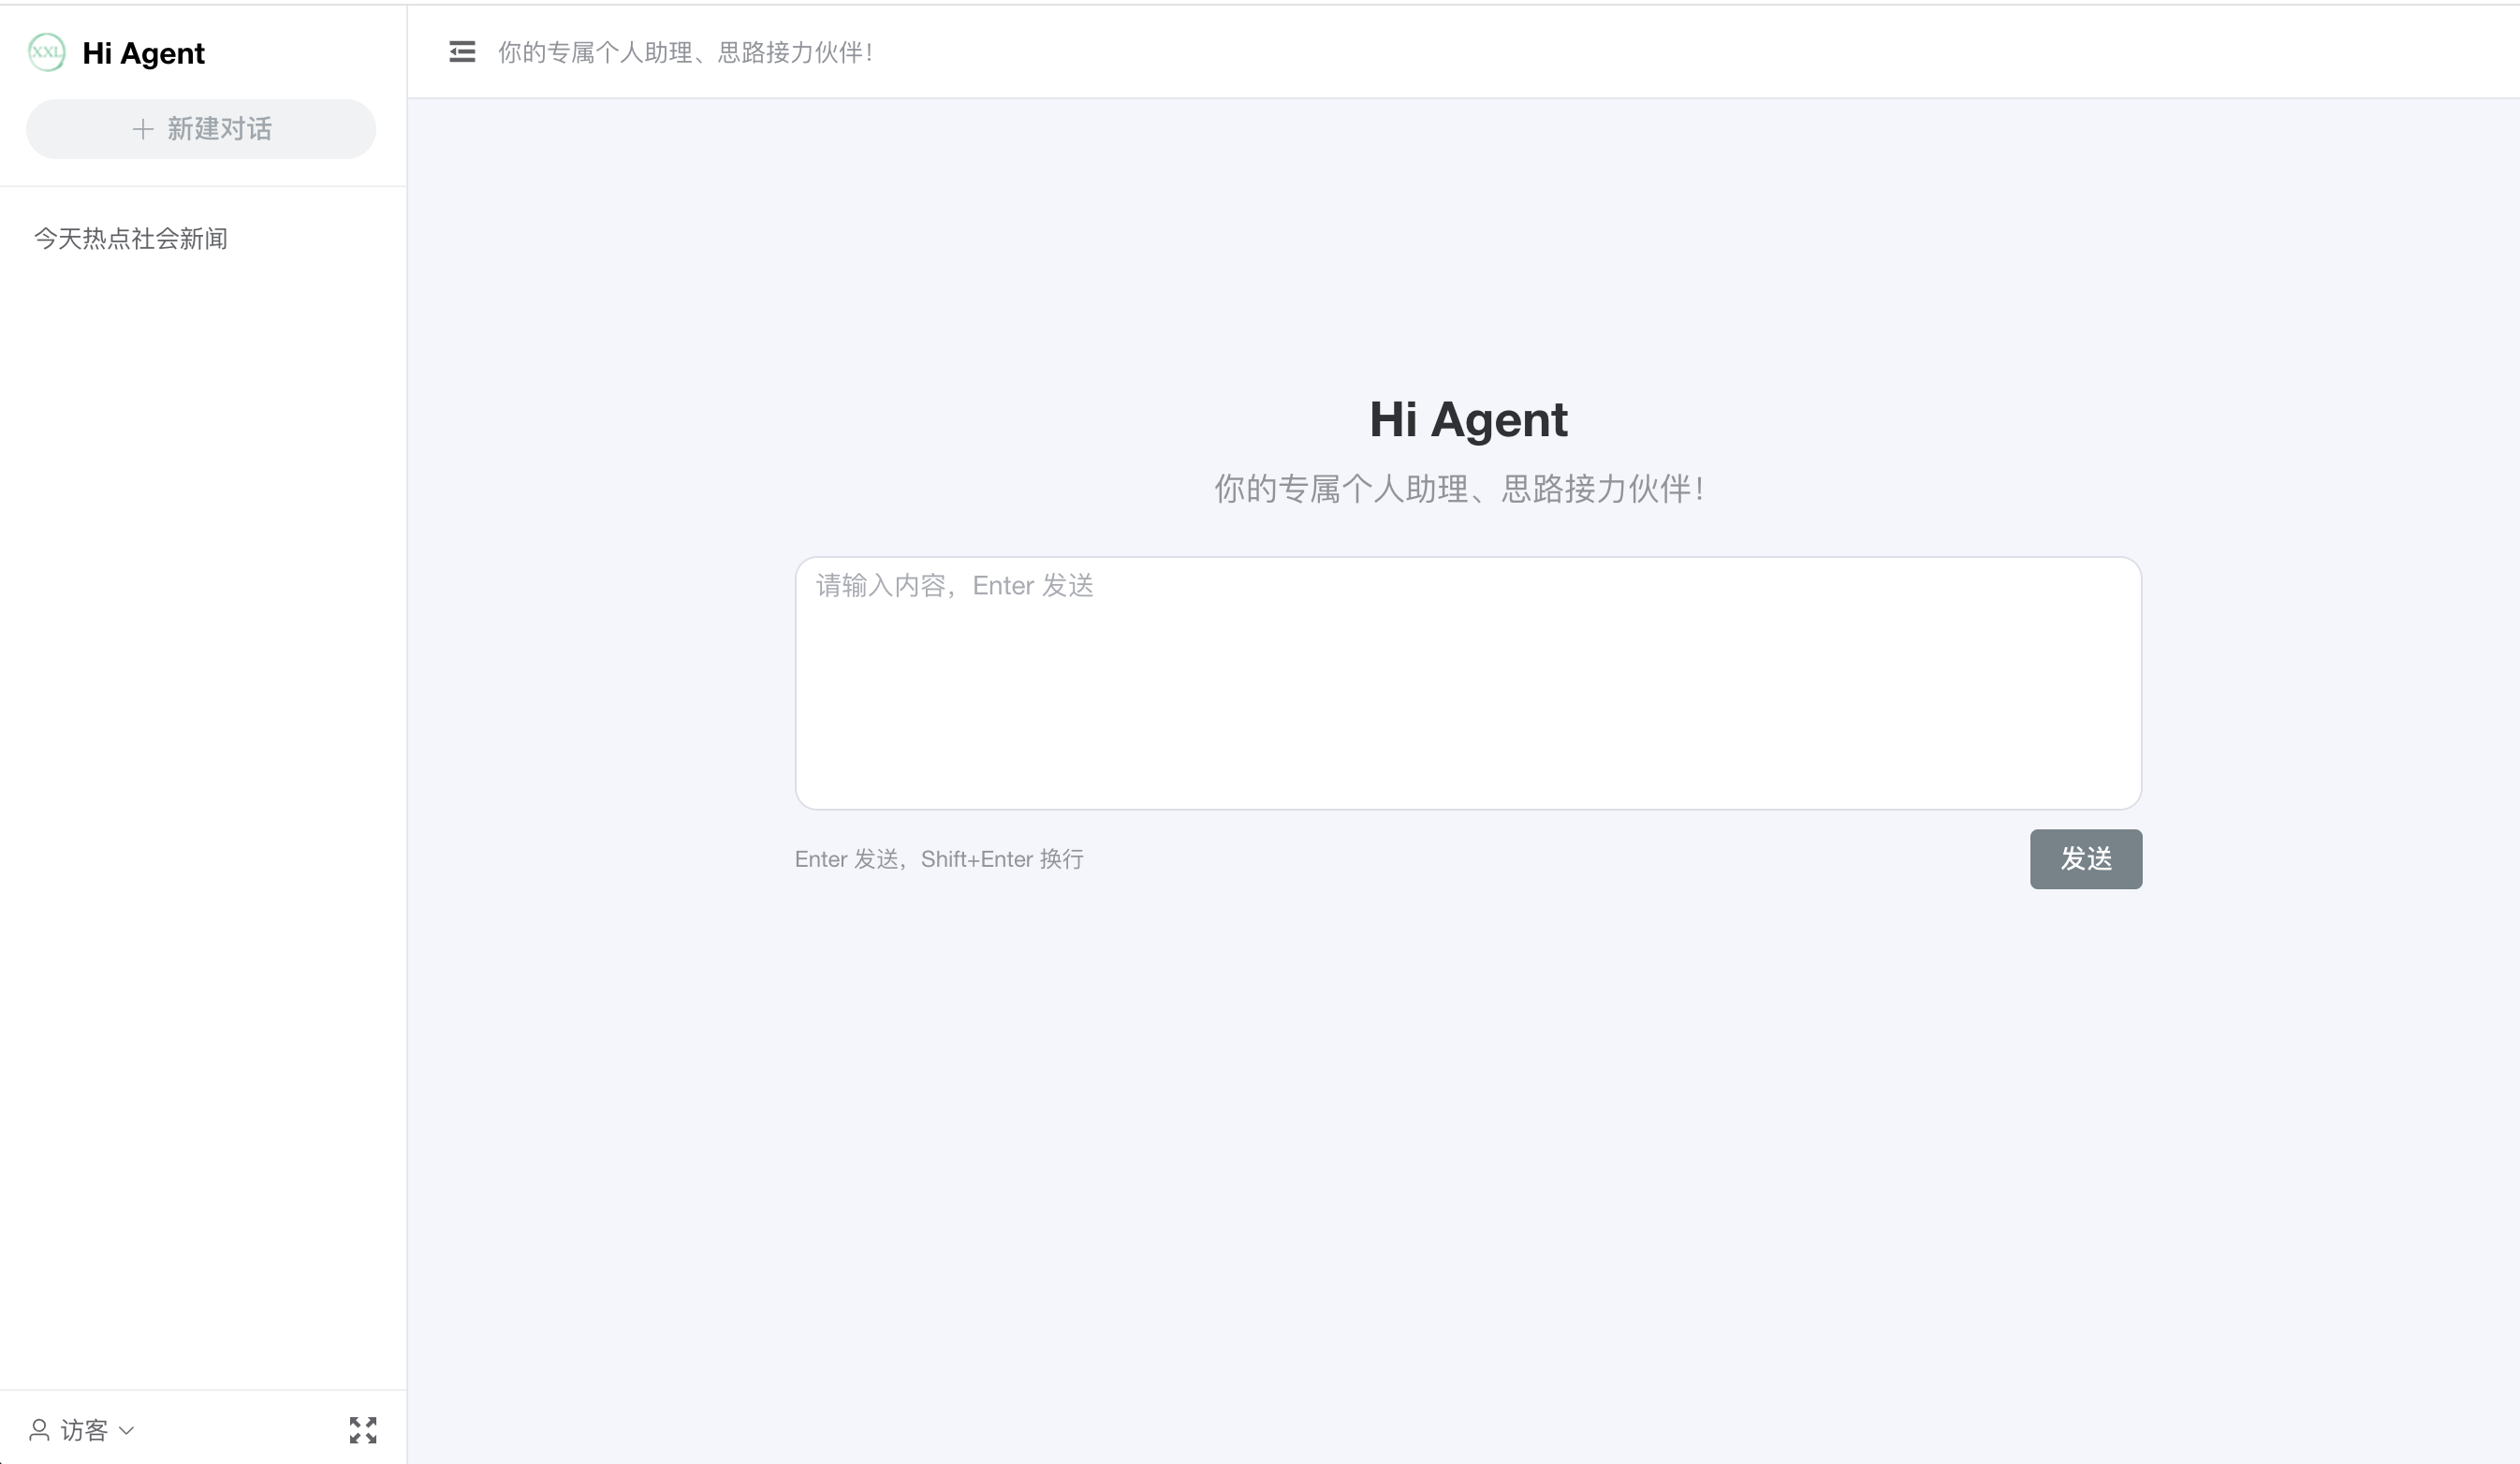
图:Agent 发布页:UUID 免登录对话入口(图片来源:XXL-AI 官方文档)
4.2 多供应商:模型工厂里的四个巧思
application.properties 里有一组很关键的配置:
spring.ai.model.chat=none
spring.ai.model.embedding=none
spring.ai.model.image=none
# ... 全部置 none
禁用了 spring-ai 的全部自动装配,因为模型配置存在数据库里、由用户在页面上改,必须在运行时程序化构建。LlmModelFactory 承担这件事,代码里有四处很见功力的处理:
① 配置指纹即缓存失效策略。 对话模型缓存是 CacheTool.newLRUCache(1000).expireAfterWrite(5min),key 为 supplierId:modelId:sessionId,value 是 (fingerprint, OpenAiChatModel)。指纹由归一化的 baseUrl、模型名、API Key、按 key 排序后的 Header 拼串做 SHA-256:
String key = runtime.getSupplierId() + ":" + runtime.getModelId() + ":" + sessionKey;
String fingerprint = configFingerprint(runtime);
ChatModelEntry entry = chatModelCache.getIfPresent(key);
if (entry != null && entry.fingerprint.equals(fingerprint)) return entry.model;  // 命中
// 否则重建并覆盖
于是供应商配置一改,指纹立刻变,旧实例自动失效,不需要到处写 cache.evict()。同样的模式在 RagTool(向量存储缓存按嵌入模型指纹)、McpClientTool(MCP 客户端按配置指纹)、SkillToolFactory(技能目录按 id:updateTime 指纹)里反复出现——"指纹 + LRU + 5min 兜底过期"是贯穿全项目的统一缓存范式。
② {session} 占位符决定缓存粒度。 自定义 Header 的 value 支持 {session},例如 OpenCode 需要 {"x-opencode-session":"{session}"}。工厂只在检测到占位符时才把 sessionId 纳入缓存键:
String sessionKey = usesSessionHeader(runtime.getHeaders()) && isNotBlank(sessionId) ? sessionId : "";
没有占位符时同一模型跨会话复用一个实例,避免每个对话都构建一个 OpenAiChatModel;有占位符时按会话隔离,防止 A 用户的会话头串到 B 用户。这个判断很细,是踩过坑才会写的。
③ BaseURL 归一化。 裸地址(如 Ollama http://host:11434,URI path 为空)自动补 /v1,保证 /chat/completions、/embeddings 能正确解析;非法 URL 不在此抛断,按原值交给后续请求报错。
④ User-Agent 覆盖用了拦截器而非 Header。 spring-ai 默认注入 User-Agent: spring-ai-openai,且 customHeaders 是 add 追加语义、无法覆盖。工厂注册 OkHttp 拦截器用 Request.Builder.header() 的覆盖语义改写为 XXL-AI:
private OpenAiHttpClientBuilderCustomizer userAgentCustomizer() {
    return builder -> builder.interceptor(chain -> chain.proceed(
        chain.request().newBuilder().header("User-Agent", "XXL-AI").build()));
}
连通测试(SupplierApiTool)也做了降级链:GET /models 返回 200 即通过;遇到 401/403 直接判认证失败;否则回退 POST /chat/completions 发一条最小请求 {"model":"test","messages":[{"role":"user","content":"hi"}]} 探活。HttpClient 连接超时 5s、单次请求超时 8s;listModels() 解析 data[].id 供"自动导入模型"使用。模型分**对话模型(type=0)/ 嵌入模型(type=1)**两级,运行时都做类型校验。
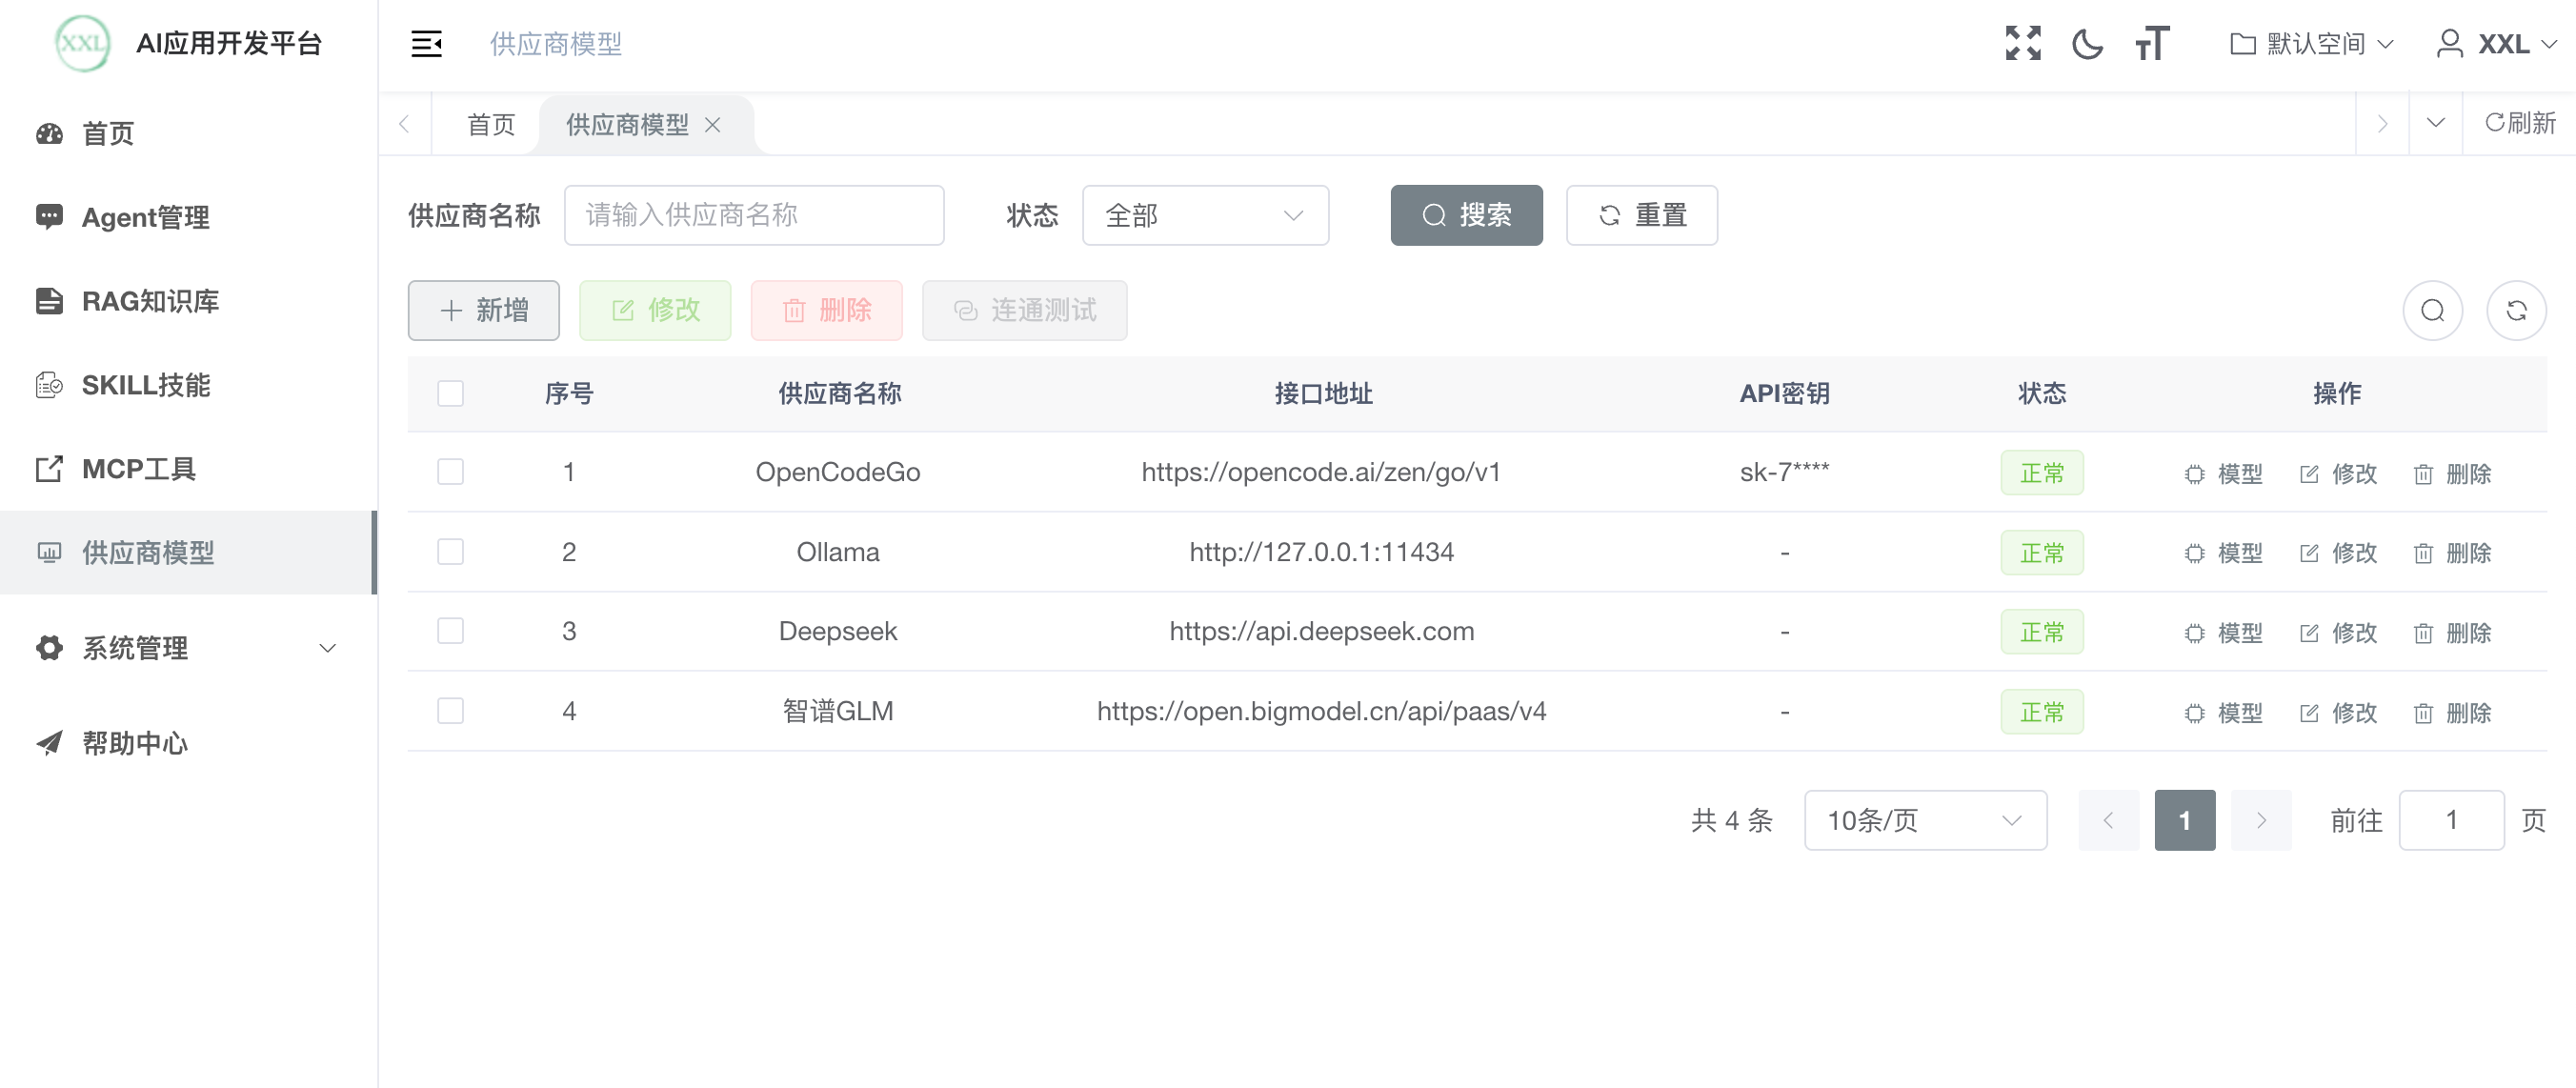
图:供应商管理:OpenCodeGo / Ollama / Deepseek / 智谱GLM(图片来源:XXL-AI 官方文档)
官方教程里这一步还提示:模型「自动导入」弹窗支持按模型标识过滤,已导入的模型会标记「已导入」避免重复;勾选供应商记录后可批量做「连通测试」,底层正是 4.2 讲的那条 /models → /chat/completions 降级链。
4.3 SSE 无状态化:全项目最硬的一段设计
为什么要做
普通 SSE 实现里,"生成"和"长连接"绑在同一个 JVM 线程上:请求打到节点 A,A 持有连接并跑 LLM;A 重启、扩缩容、客户端刷新,流式内容就丢了,集群还得配粘性会话(sticky session)。XXL-AI 的解法是把生成与下发彻底拆开。
完整链路(ChatStreamTool.java,967 行)
POST /chat/send(ChatController → ChatServiceImpl.send)
  ├─ requireReadyAgent(uuid)       校验存在 + 已发布
  ├─ sessionService.require(...)   校验会话归属
  ├─ openRound(...)                落库用户消息(status=1) + 助手占位(status=0)
  │                                → 得到 msgId
  ├─ chatStreamTool.submit(...)    XADD 任务队列
  └─ chatStreamTool.open(msgId,null) → 独立线程池 XREAD 结果流 → SSE
                    │
        Redis Stream 任务队列 xxl:ai:chat:tasks(消费组 default-group)
                    ▼
  worker(任意节点,SmartLifecycle 拉起 workerCount 个守护线程)
        XREADGROUP → handleTask → llmChat(装配 → LlmChatTool 流式)
        增量回调 → XADD 结果流 xxl:ai:chat:result:{msgId}
        结束 → 回填 SessionMsg(status=1/2) + 写 done/error + XACK
                    │
        任意节点的 SSE 线程 XREAD 结果流 → 事件(带 SSE id)
        断线 → POST /chat/resume?msgId&lastEventId 从断点重放,不重新生成
关键约定:助手占位消息的主键 msgId 同时是结果流标识,一轮对话 = 一条助手消息 = 一条结果流。前端刷新后发现 status=0(生成中)就自动拿 msgId 走 /chat/resume,把已生成的 token 全部重放回来。
三个 Redis key 以源码为准:任务队列 xxl:ai:chat:tasks、消费组 default-group、结果流 xxl:ai:chat:result:{msgId}、记忆归档锁 xxl:ai:memory:archive:lock。
事件协议
| 事件 | data | 是否带 SSE id |
说明 |
|---|---|---|---|
stream |
msgId |
否 | 连接建立即下发,客户端据此续传 |
thinking |
思考增量 | 是 | 推理模型 reasoningContent 增量 |
message |
正文增量 | 是 | Markdown 文本增量 |
ping |
ping |
否 | 空闲心跳,防网关/浏览器断开 |
done |
空 | 是 | 生成结束终态 |
error |
错误提示 | 是 | 生成失败终态 |
LlmChatTool 里还有个容易忽略的细节:思考过程由 spring-ai 返回累积全量 reasoningContent,需要 computeReasoningDelta(prev, current) 用 startsWith 取首现差异子串转成增量;且增量判空必须用 isNotEmpty 而非 isNotBlank——模型会单独下发 "\n",用 isNotBlank 会吞掉换行。历史消息注入时又刻意只放回复内容、不放思考过程,避免推理上下文膨胀。
可靠性设计清单
| 机制 | 实现 | 作用 |
|---|---|---|
| 无状态转发 | 结果流在 Redis | 任一节点可服务任一连接,无需粘性会话 |
| 至少一次消费 | XREADGROUP + 结束 XACK |
worker 宕机后 PEL 里的任务可被认领 |
| 宕机认领 | 每 60s 扫 PEL,XCLAIM 阈值 = streamTimeout + 60s |
阈值大于单次生成最长耗时,不误抢在途任务 |
| 生成不受连接影响 | worker 独立于 SSE 线程 | 客户端断开,worker 仍完成生成并落库 |
| 结果流保留 | TTL 600s,非终态按半 TTL 续期,终态写入时直接设定 | 刷新/断线的续传时间窗 |
| 连接容错 | Redis 连续读失败 3 次才中断;转发线程池满回退"服务繁忙" | 抖动不误杀 |
| 线程池 | core = sseMax/8、max = 64、queueCapacity=0(SynchronousQueue) |
长连接不排队,并发能真扩到 max |
| 自愈 | 任务流被 flush 丢失时自动 createGroup 重建 |
运维误操作可恢复 |
| 主动终止 | /chat/stop → RunContext 中断线程 + SkillShellTracker.cancel() 回收子进程 |
避免工具调用进程泄露 |
配置集中在 application.properties:
xxl-ai.chat.stream.timeout=180000   # 单次生成/单连接最长 180s
xxl-ai.chat.stream.ttl=600          # 结果流保留 600s
xxl-ai.chat.worker.count=4          # 单节点生成 worker 线程数
xxl-ai.chat.sse.max=64              # 单节点 SSE 转发最大并发
xxl-ai.chat.history.limit=50        # 附加给模型的最近历史消息条数
内部常量:XREAD 阻塞窗口 5000ms、单次批量 50 条、任务流近似裁剪上限 5000。
一轮对话的装配顺序(ChatStreamTool.llmChat)
① 复校 Agent(worker 可能与请求节点不同)→ 加载 SupplierRuntime → 校验 modelType==0
② 历史消息:listRecentBySessionId(sessionId, msgId, 50) → 按 id 升序还原时序
            → 跳过 status=0 的半截助手占位 → 移除末尾重复的当前提问
③ 系统指令:Agent.systemPrompt(为空则返回 "")
④ 长期记忆:memoryStatus==1 时 injectMemory(失败降级为原指令)
⑤ 工具:MCP ToolCallbacks + SkillsTool + Shell/FileSystem/Glob/Grep/ListDirectory
⑥ RAG:逐个知识库 buildAdvisor;单库失败写「【知识库降级】…」到思考流后跳过
⑦ LlmChatTool.chat(...) → 增量回调写结果流
降级贯穿始终:记忆注入失败降级、单库 RAG 装配失败跳过并把提示写进思考流(保证刷新重放后内容一致)、任务投递失败立即把占位消息回填失败态、生成失败先回填正文再发 error(避免前端卡在"思考中")。这背后是同一条哲学:辅助能力永不阻塞主流程。
4.4 RAG:一个知识库一个 Milvus 集合
RagTool(427 行)内聚了分片、嵌入模型解析、向量存储、检索、清理与 Advisor 装配:
- 集合隔离:
collectionName(baseId) = "kb_base_" + baseId,MetricType.COSINE+IndexType.FLAT+initializeSchema(true);手动构建的MilvusVectorStore不触发 Spring 生命周期回调,必须显式store.afterPropertiesSet()建集合/索引/加载——代码里专门注释了这一坑。 - 分片:
split(content, chunkSize, chunkOverlap)是纯字符级滑窗,默认chunk_size=500、chunk_overlap=50、top_k=5(DDL 默认值);overlap被 clamp 到[0, size-1],避免start不前进导致死循环。 - 元数据:每个分片写成
Document(text, {docId, chunkIndex});重复向量化时先按FilterExpressionBuilder().eq("docId", docId)删旧向量再写,支持幂等重跑。 - 注入:
QuestionAnswerAdvisor.builder(vectorStore).searchRequest(topK)交给 spring-ai 的 Advisor 链,检索结果自动拼进上下文。 - 缓存:向量存储按
baseId缓存,条目内记录嵌入模型配置指纹,指纹变化即重建(v1.4.0 修过这个 bug,Release Notes 里明确写"缓存 Key 新增模型指纹信息")。
能力边界:✓ 结构清晰、按库隔离、模型变更自动重建;✗ 目前文档管理只支持粘贴文本与 txt / md 上传,无 PDF / Word / 图片解析,无混合检索与 rerank,字符级分片对中文语义边界不敏感。仓库 TODO LIST 里"多类型文档(Word / PDF / 图片)解析与向量化"仍待办。若业务是"文档密集型问答",RAGFlow / FastGPT 这类专做文档理解的引擎更合适。
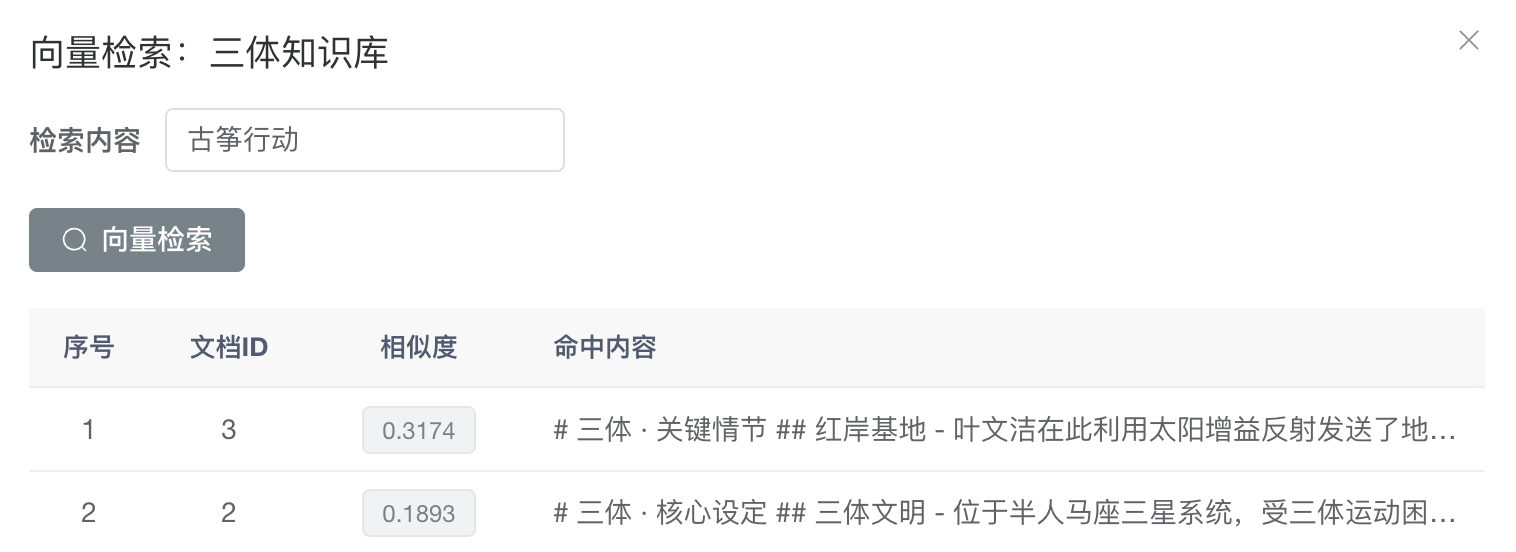
图:向量检索测试:返回命中文档、相似度与命中内容(图片来源:XXL-AI 官方文档)
官方教程把「向量检索」当作调参验证环节:向量化完成后先输入一句话,看命中的分片、相似度与内容,确认分片大小/重叠是否合适,再把知识库绑定到 Agent。这与源码里 RagTool.search() 返回 {text, docId, chunkIndex, score} 的结构一一对应。
4.5 MCP:把外部工具桥接成 spring-ai ToolCallback
McpClientTool(570 行)基于官方 Java MCP SDK 2.1.0,两个传输:
HttpClientStreamableHttpTransport  // 远程,Streamable HTTP
StdioClientTransport               // 本地,ServerParameters(command/args/env/cwd)
值得记住的是 2025-03-26 的 MCP 规范修订里,官方用 Streamable HTTP 取代了早期的 HTTP+SSE 传输(同时引入 OAuth 2.1、JSON-RPC batching、tool annotations)。XXL-AI 云版与 Desk 版都跟进了这一版传输,属于"对齐开放规范"而非自造协议。
桥接逻辑在 McpToolFactory:把 tools/list 返回的每个工具包装成 spring-ai FunctionToolCallback,inputSchema 直接透传 MCP 的 JSON Schema(为空时补 {"type":"object","properties":{}},规避部分服务未声明属性被供应商拒绝),工具名做 slugify(mcpName) + "__" + 原始工具名 去冲突,调用落地回 McpClientTool.callTool()。加入 ChatClient 后由 spring-ai 的 ToolCallingAdvisor 统一驱动工具循环,项目没有手写 tool_calls 循环。单个 MCP 服务加载失败只记日志跳过,不影响其他服务。
仓库附带 xxl-ai-sample(:8091,端点 /sample/mcp)作为开箱即用的联调靶子,用 spring-ai 的 @McpTool 注解暴露两个工具:get_current_time 与 calculator——后者还自带一个递归下降的四则运算解析器,用正则白名单 [0-9+\-*/().\s]+ 挡住任意代码执行,是很好的"最小安全 MCP 工具"范例。
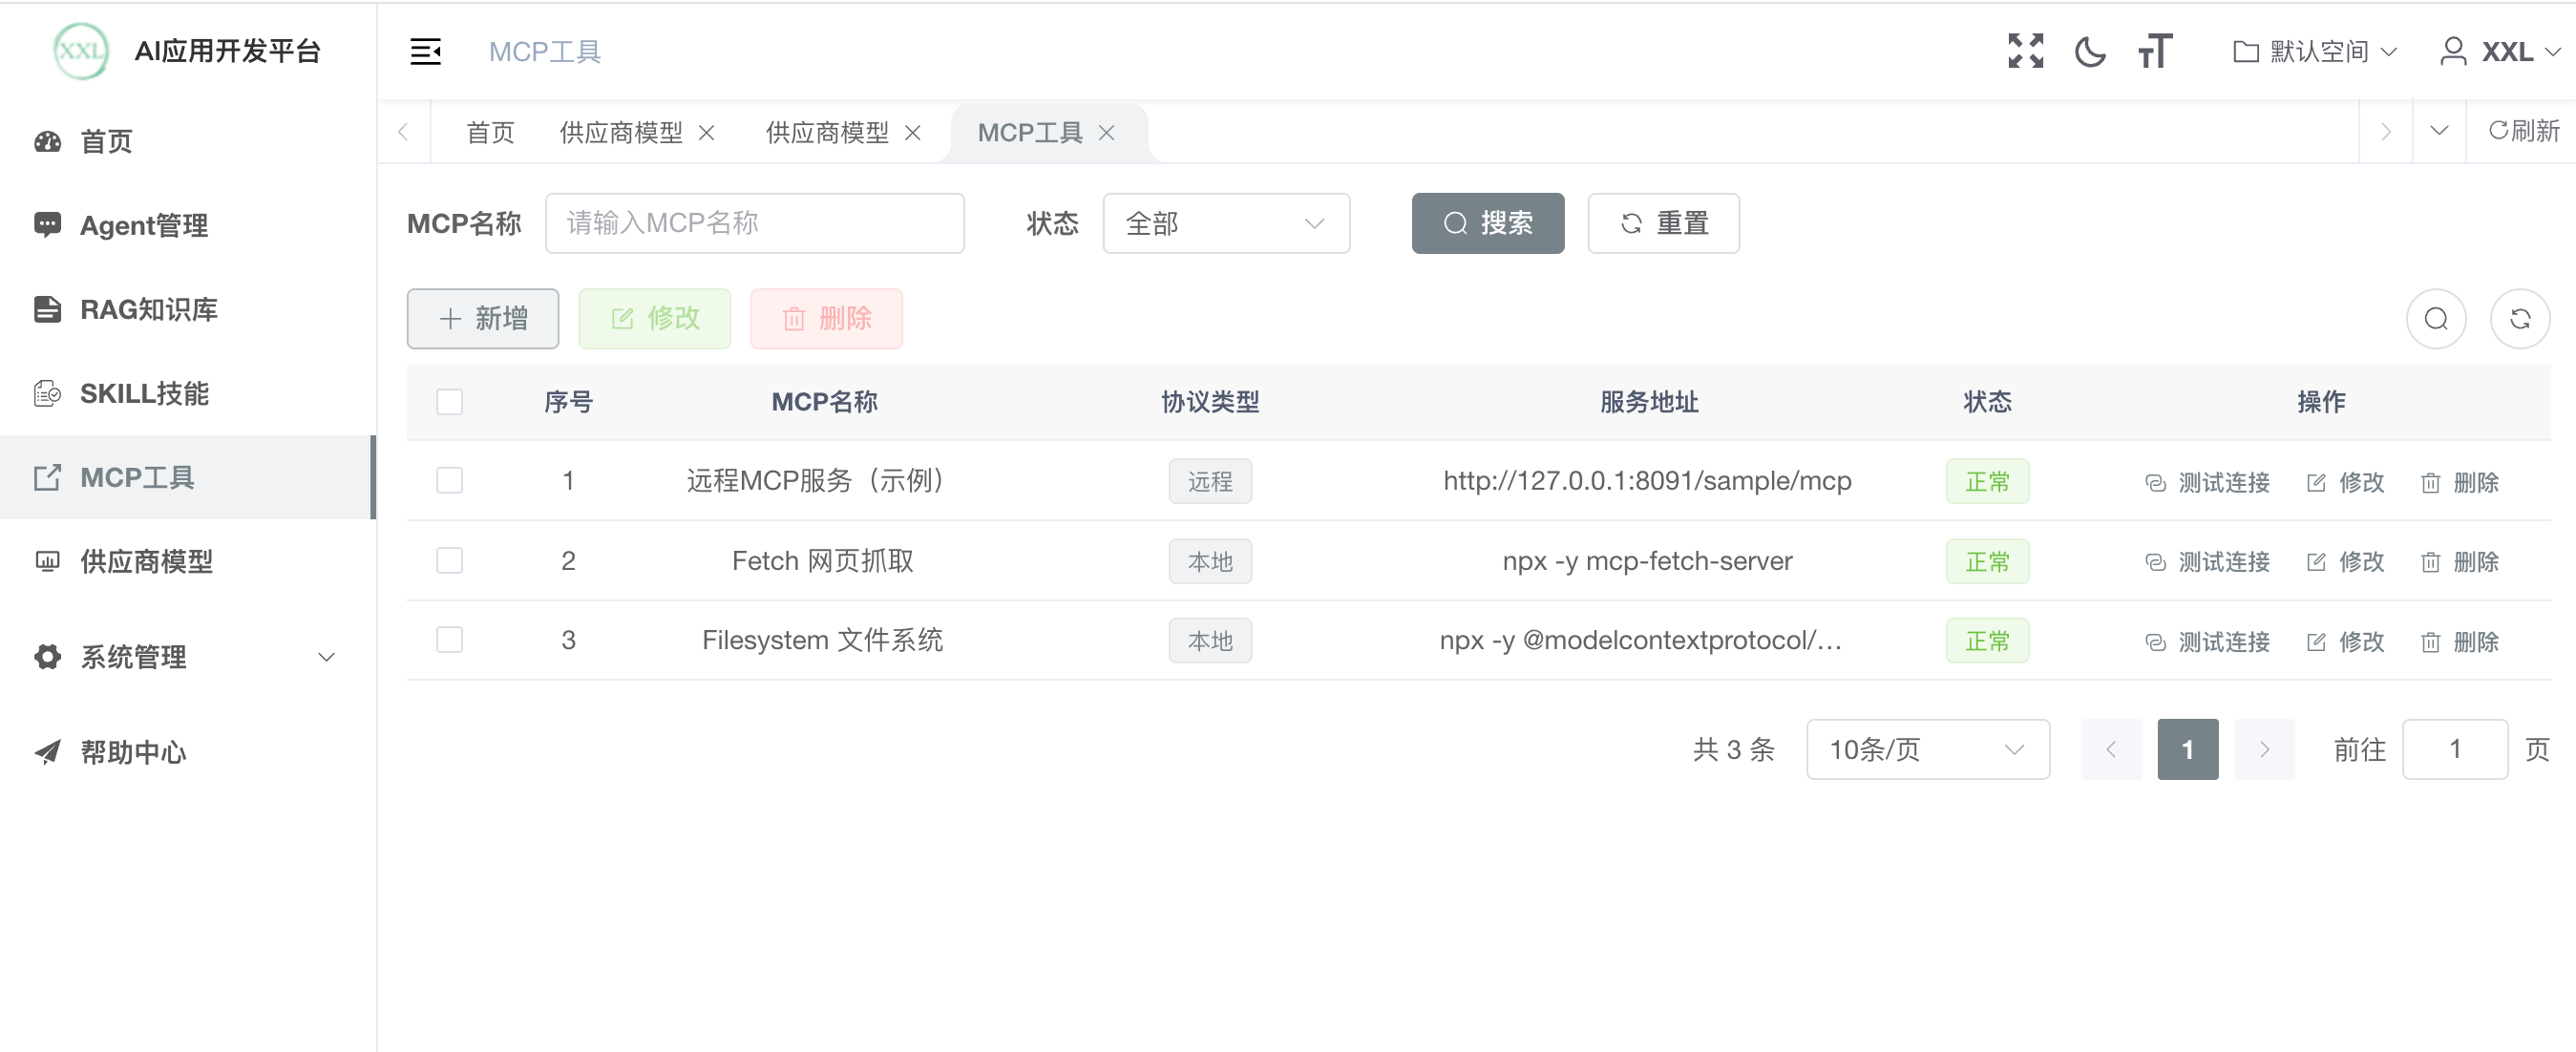
图:MCP 工具管理:远程 Streamable HTTP 示例 + 本地 stdio 服务(图片来源:XXL-AI 官方文档)
新增服务时远程填 URL + Headers、本地填 command / args / env / cwd;保存后点「测试连接」,界面会回显服务名称、版本、可用工具数量、耗时与工具清单(名称/标题/介绍)——对应源码 McpClientTool.test() 里的 initialize() + listTools() 两次调用。
4.6 SKILL:把数据库里的文件树物化成可执行目录
SKILL 源自 Anthropic 的 Agent Skills 规范:一个含 SKILL.md 的目录,YAML frontmatter 提供 name/description/version,靠"元数据常驻 → 命中读全文 → 按需读附属脚本"的渐进式披露省 token。
XXL-AI 云版的实现很"数据库":管理端以文件树 + Markdown 编辑器维护 SKILL.md、scripts/、reference/(三个固定节点不可删改移),内容存 xxl_ai_skill_file 表;运行时 SkillToolFactory 把它物化到磁盘:
${xxl-ai.skill.root}/agent_{agentId}/
├── .fingerprint                 # 指纹标记
├── {skillName}/SKILL.md
├── {skillName}/scripts/
└── {skillName}/reference/
- 指纹:
skillId:updateTime拼接串,写侧改内容即刷新update_time;不一致就整目录清空重建(杜绝换绑/删除后的残留文件),并写.fingerprint标记做本地校验。 - 并发:按
agentId加锁 + 双重检查,避免并发重建互相破坏目录。 - 安全:
sanitize()把\、/、..全部替换成_,防目录穿越;agent_{agentId}天然做到 Agent 级沙箱隔离。 - 执行工具:
SkillsTool+ShellTools/FileSystemTools/GlobTool/GrepTool/ListDirectoryTool,全部allowedDirectory(agentRoot)限定;Shell 经SkillShellTracker登记,会话终止或生成结束统一回收进程。
部署提醒:
xxl-ai.skill.root=/data/applogs/xxl-ai/skills/是本地磁盘路径。集群部署时每个节点各自物化一份(有本地缓存倒也能跑),但官方文档明确建议"集群建议挂载共享持久卷",否则技能内容变更在不同节点生效时机可能不一致。
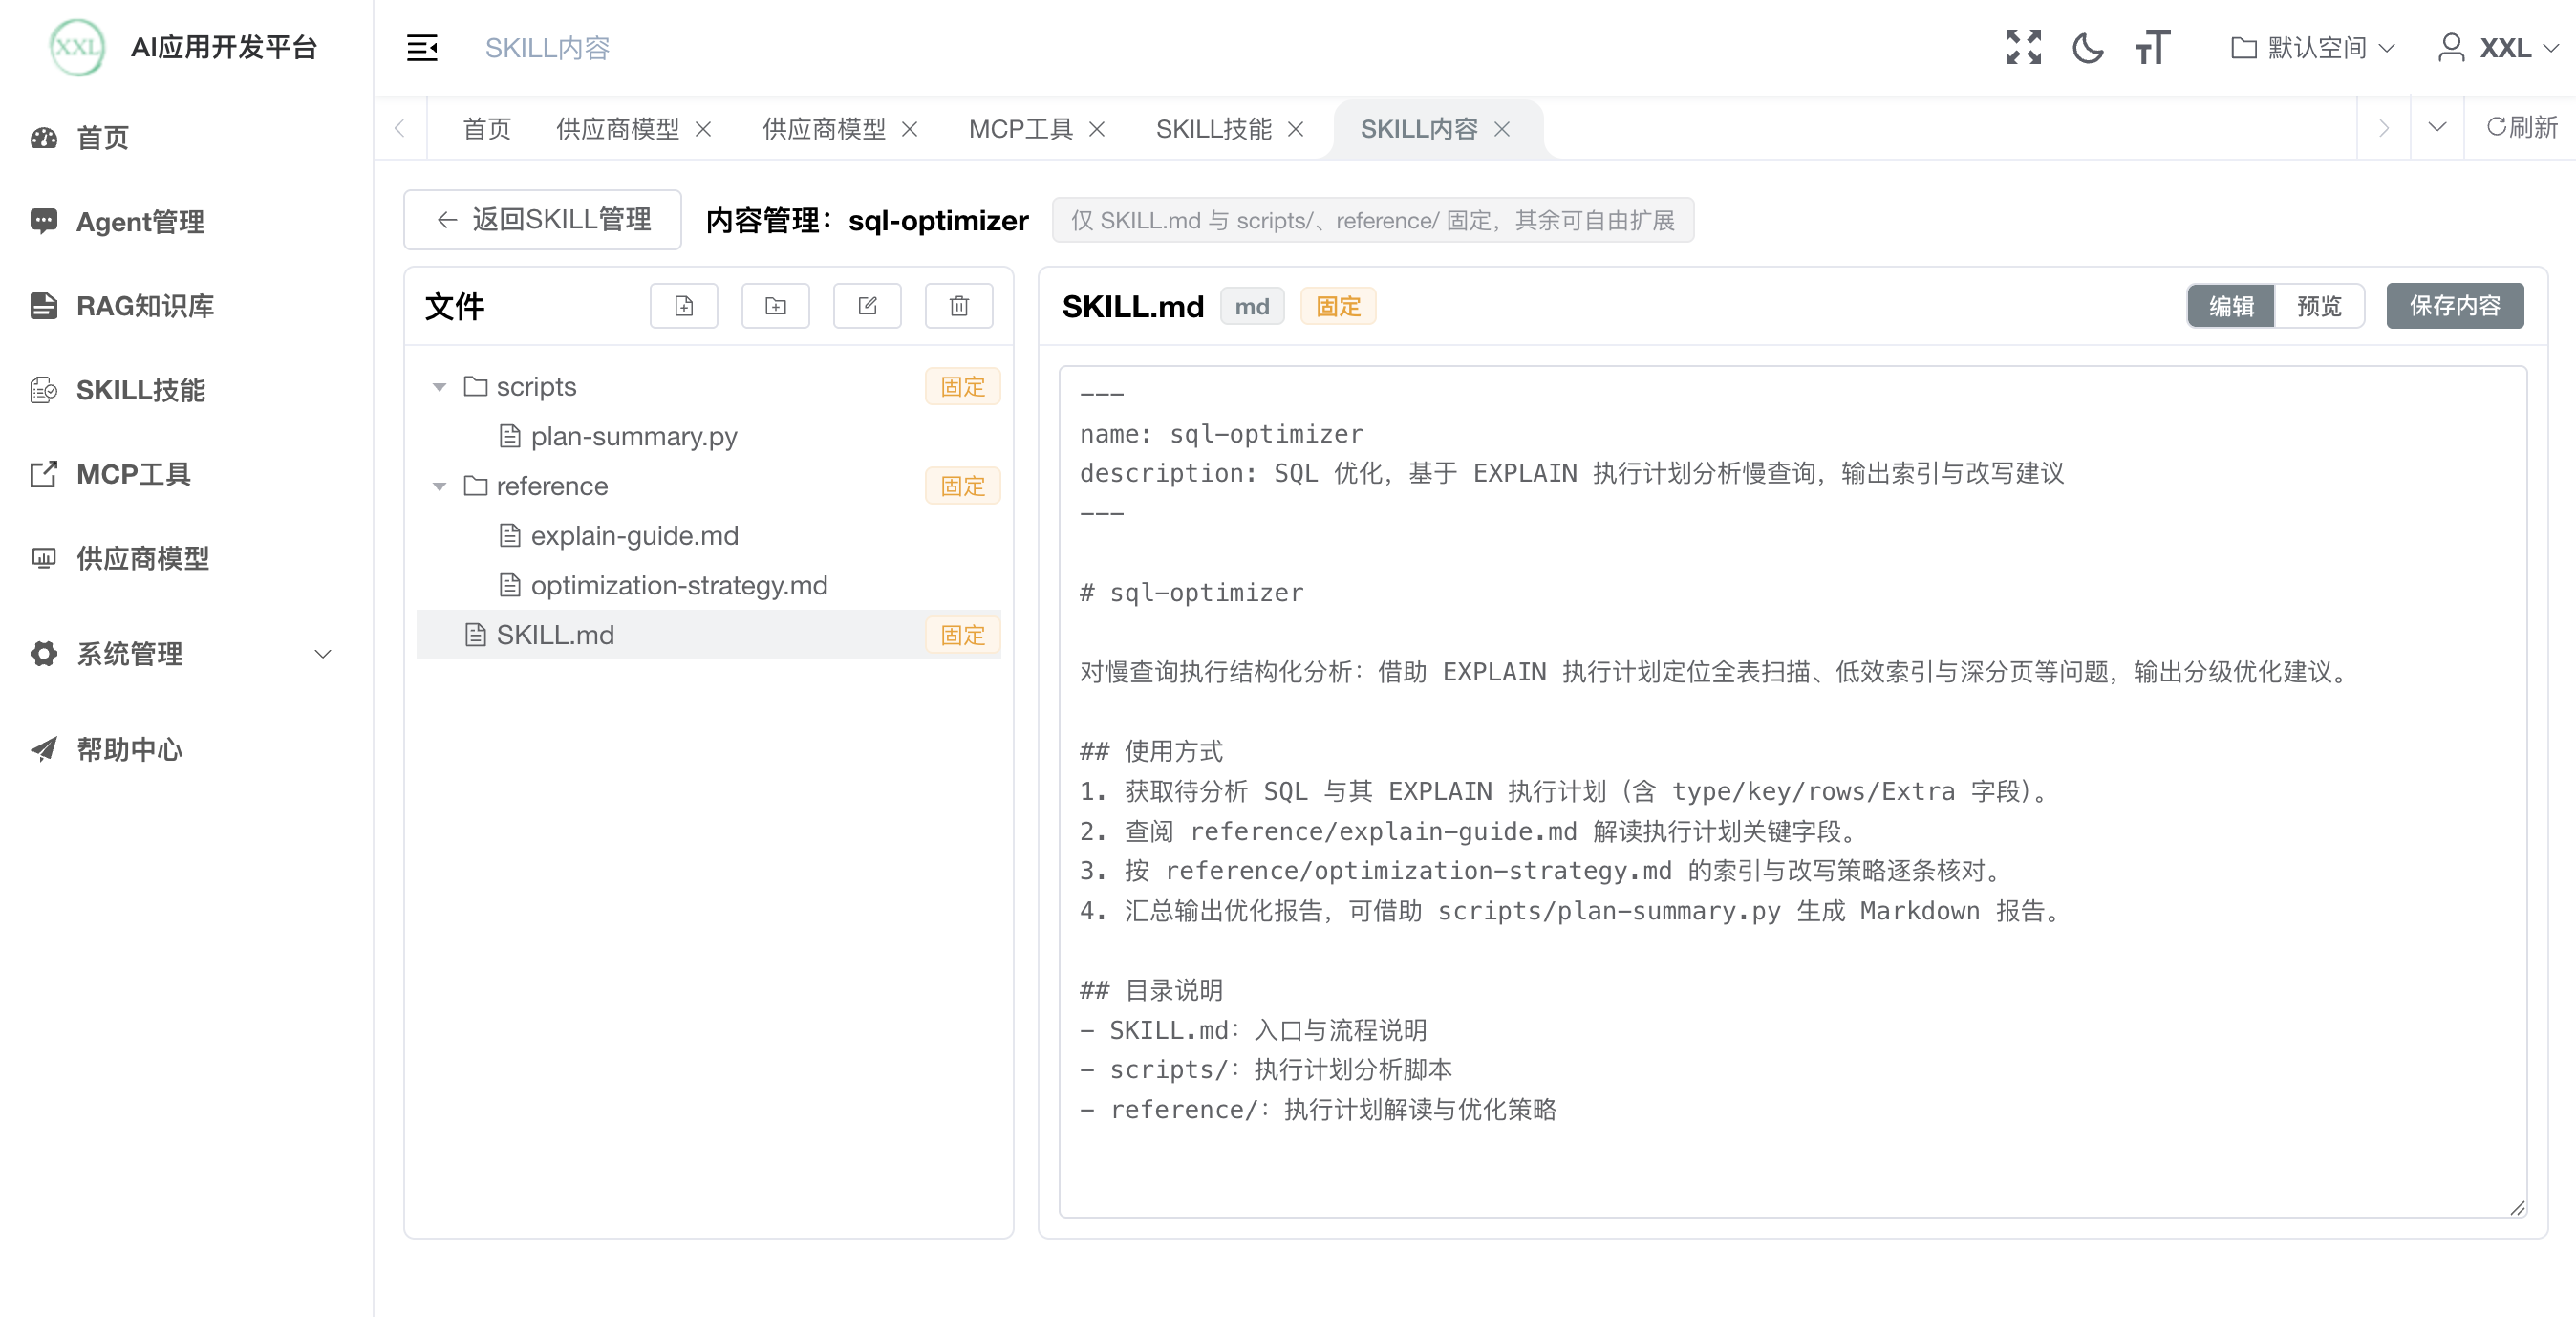
图:SKILL 内容管理:文件树 + SKILL.md 在线编辑(图片来源:XXL-AI 官方文档)
官方教程明确:SKILL.md 与 scripts/、reference/ 是固定节点(列表中标记「固定」),禁止删除、改名与移动;其余目录/文件可自由新增、重命名、移动、编辑与预览。内容变更刷新 update_time 后,Agent 下次使用会按 4.6 讲的指纹机制自动重新物化。
4.7 记忆体系:四类记忆各归其位
这是 XXL-AI 设计感最强的一块。它把认知科学的记忆分类直接映射成代码模块:
| 记忆类型 | 落点 | 存储 |
|---|---|---|
| 短期 / 工作记忆 | SessionMsg + ChatStreamTool |
xxl_ai_session_msg(含 reasoning、status 状态机) |
| 情景记忆(画像/偏好) | Memory + MemoryTool + MemoryArchiveTool |
xxl_ai_memory,Agent × 访客唯一键 |
| 语义记忆(共享知识) | knowledge + RagTool |
Milvus 向量集合 |
| 程序记忆(技能) | skill + SkillToolFactory |
物化的可执行技能目录 |
铁律:记忆的生成与消费解耦——对话时只读记忆、绝不阻塞生成去写记忆,写入交给后台定时器。
长期记忆是"巩固式"的:单字段 Markdown,按固定五个维度分节(用户画像 / 偏好习惯 / 关键事实 / 目标与意图 / 近期进展),无内容的维度整节省略,默认 2000 字符上限(可通过系统配置 memory.content.max.length 调整)。选 Markdown 而非多表多字段的理由很实在:记忆要直接拼进系统指令给模型看,Markdown 是模型的"母语"。
MemoryTool 三件事:loadMemory(agentId, visitorId)、mergePrompt(base, memory)、generate(agent, oldMemory, newMsgs, maxLen)。其中 mergePrompt 追加了一句护栏:
「若与用户当前表述冲突,以当前表述为准」——防止"记忆反噬"把过时信息当圣旨。
generate 还带一个 normalizeMarkdown(),用 7 条正则纠正模型偶发的"标题与内容压成一行"(如 ##偏好习惯-沟通风格…),保证注入格式稳定。
归档用增量水位线(MemoryArchiveTool,SmartLifecycle):
CyclicThread 60s 心跳
  → Redis SETNX 抢锁 xxl:ai:memory:archive:lock(TTL=60s,处理完立即释放)
  → 遍历开启记忆的 Agent × 每个访客
  → 比较 max(msgId) 与 last_msg_id(水位线)
  → 只取 id > 水位线 的新消息 → generate(历史记忆 + 新消息)
  → upsert(唯一键 agent_id + visitor_id,天然幂等)→ 推进水位线
这套设计诚实承认了代价:抽取延迟(故异步)、幻觉污染(固定维度 + 定长截断 + 管理端 pageList/update/delete 人工纠偏)、2000 字符上限导致"近期进展"不断覆盖旧内容(本质是滚动窗口式遗忘,属有意取舍)。
4.8 权限与空间隔离:Java 中后台的老本行
- 登录:
@XxlSso注解鉴权,登录态存 Redis(key 前缀xxl_sso_user:),xxl-sso.token.timeout=604800000(7 天),天然支持集群与 SSO 集成;公开端/chat/**全部@XxlSso(login = false)。 - RBAC 用枚举不用表:
XxlRoleEnum只有ADMIN("admin")/USER("user"),buildRoleResources()静态构建菜单资源列表(首页、Agent 管理、对话和记忆、RAG 知识库、SKILL、MCP、供应商模型、帮助中心为公共;系统管理仅管理员)。原来的xxl_ai_resource表被删除,改为「枚举 + 静态资源」——新增页面在对应角色分支追加一条res(...)即可,动态菜单下发、前端零路由改动,按钮用v-hasPermi校验。 - 空间隔离:除平台表外所有业务表带
space_id;管理端切空间后请求头带xxl-space-id,后端统一过滤;xxl_ai_user_space维护授权,管理员可见全部空间。公开端以uuid + visitorId隔离,不进入管理端权限体系。 - 无数据库外键:所有关联应用层维护,这是 XXL 系列一贯的风格(换库成本低,一致性靠业务代码保证)。
五、本地版 Desk:三进程架构与「权限即边界」
5.1 三进程与启动顺序
┌────────────────────────────────────────────────────────┐
│ Renderer(Vue3 + Element Plus)                         │
│  会话列表 · 对话流 · Composer · 设置 · 工具面板          │
└──────────────▲─────────────────────────────────────────┘
               │ contextBridge → window.desk.*(preload 白名单)
┌──────────────┴─────────────────────────────────────────┐
│ Main(Electron 主进程)                                 │
│  窗口/生命周期 · IPC 网关 · SQLite(Drizzle) 持久化        │
│  Agent 运行时托管 · 越界审批编排 · 文件/终端/浏览器服务    │
└──────────────┬─────────────────────────────────────────┘
               │ utilityProcess + parentPort 结构化消息
┌──────────────▼─────────────────────────────────────────┐
│ Agent 运行时进程(utilityProcess)                       │
│  Pi Runtime(pi-agent-core + pi-ai)                    │
│  多供应商 LLM · Agent 循环 · 工具调用 · 沙箱 · 事件流     │
└────────────────────────────────────────────────────────┘
源码核实的启动顺序(src/main/index.ts):
app.requestSingleInstanceLock()   ← 模块顶层,防多开争 SQLite
app.whenReady()
  → initLogger → initDatabaseFromModules → setMainLanguage
  → purgeExpiredTraces → cleanupGithubArchiveTemps → ensureSeedProviders
  → registerLocalFileProtocol → registerIpc → createWindow
before-quit → preventDefault → disposeAgentRuntime(6000ms)
            → disposeAllTerminals/FsWatch/NoteWatch/GitWatch → app.quit()
webPreferences 实际为 contextIsolation: true、nodeIntegration: false、sandbox: false、webviewTag: true。三进程在构建上的体现是 electron.vite.config.ts 的 main / preload / renderer 三个配置块,而 Agent runtime 是 main 块内的第二个 rollup input(src/modules/agent/worker/worker.ts → out/main/agent/worker/worker.js),由 utilityProcess.fork() 以 serviceName: 'xxl-ai-desk-agent' 拉起。
跨进程协议定义在 agentProtocol.ts:请求 12 种(run/abort/evict/clear-permissions/reset/shutdown/interaction-response/mcp-test/mcp-tools/memory-generate/summary-generate/browser-action-result),消息 14 种(event/open-browser/.../llm-trace),主进程侧 HostEvent 8 种。增量事件在 worker 侧按 COALESCE_MS=40 合批后跨进程发送,避免每个 token 一次 IPC 打爆渲染层。
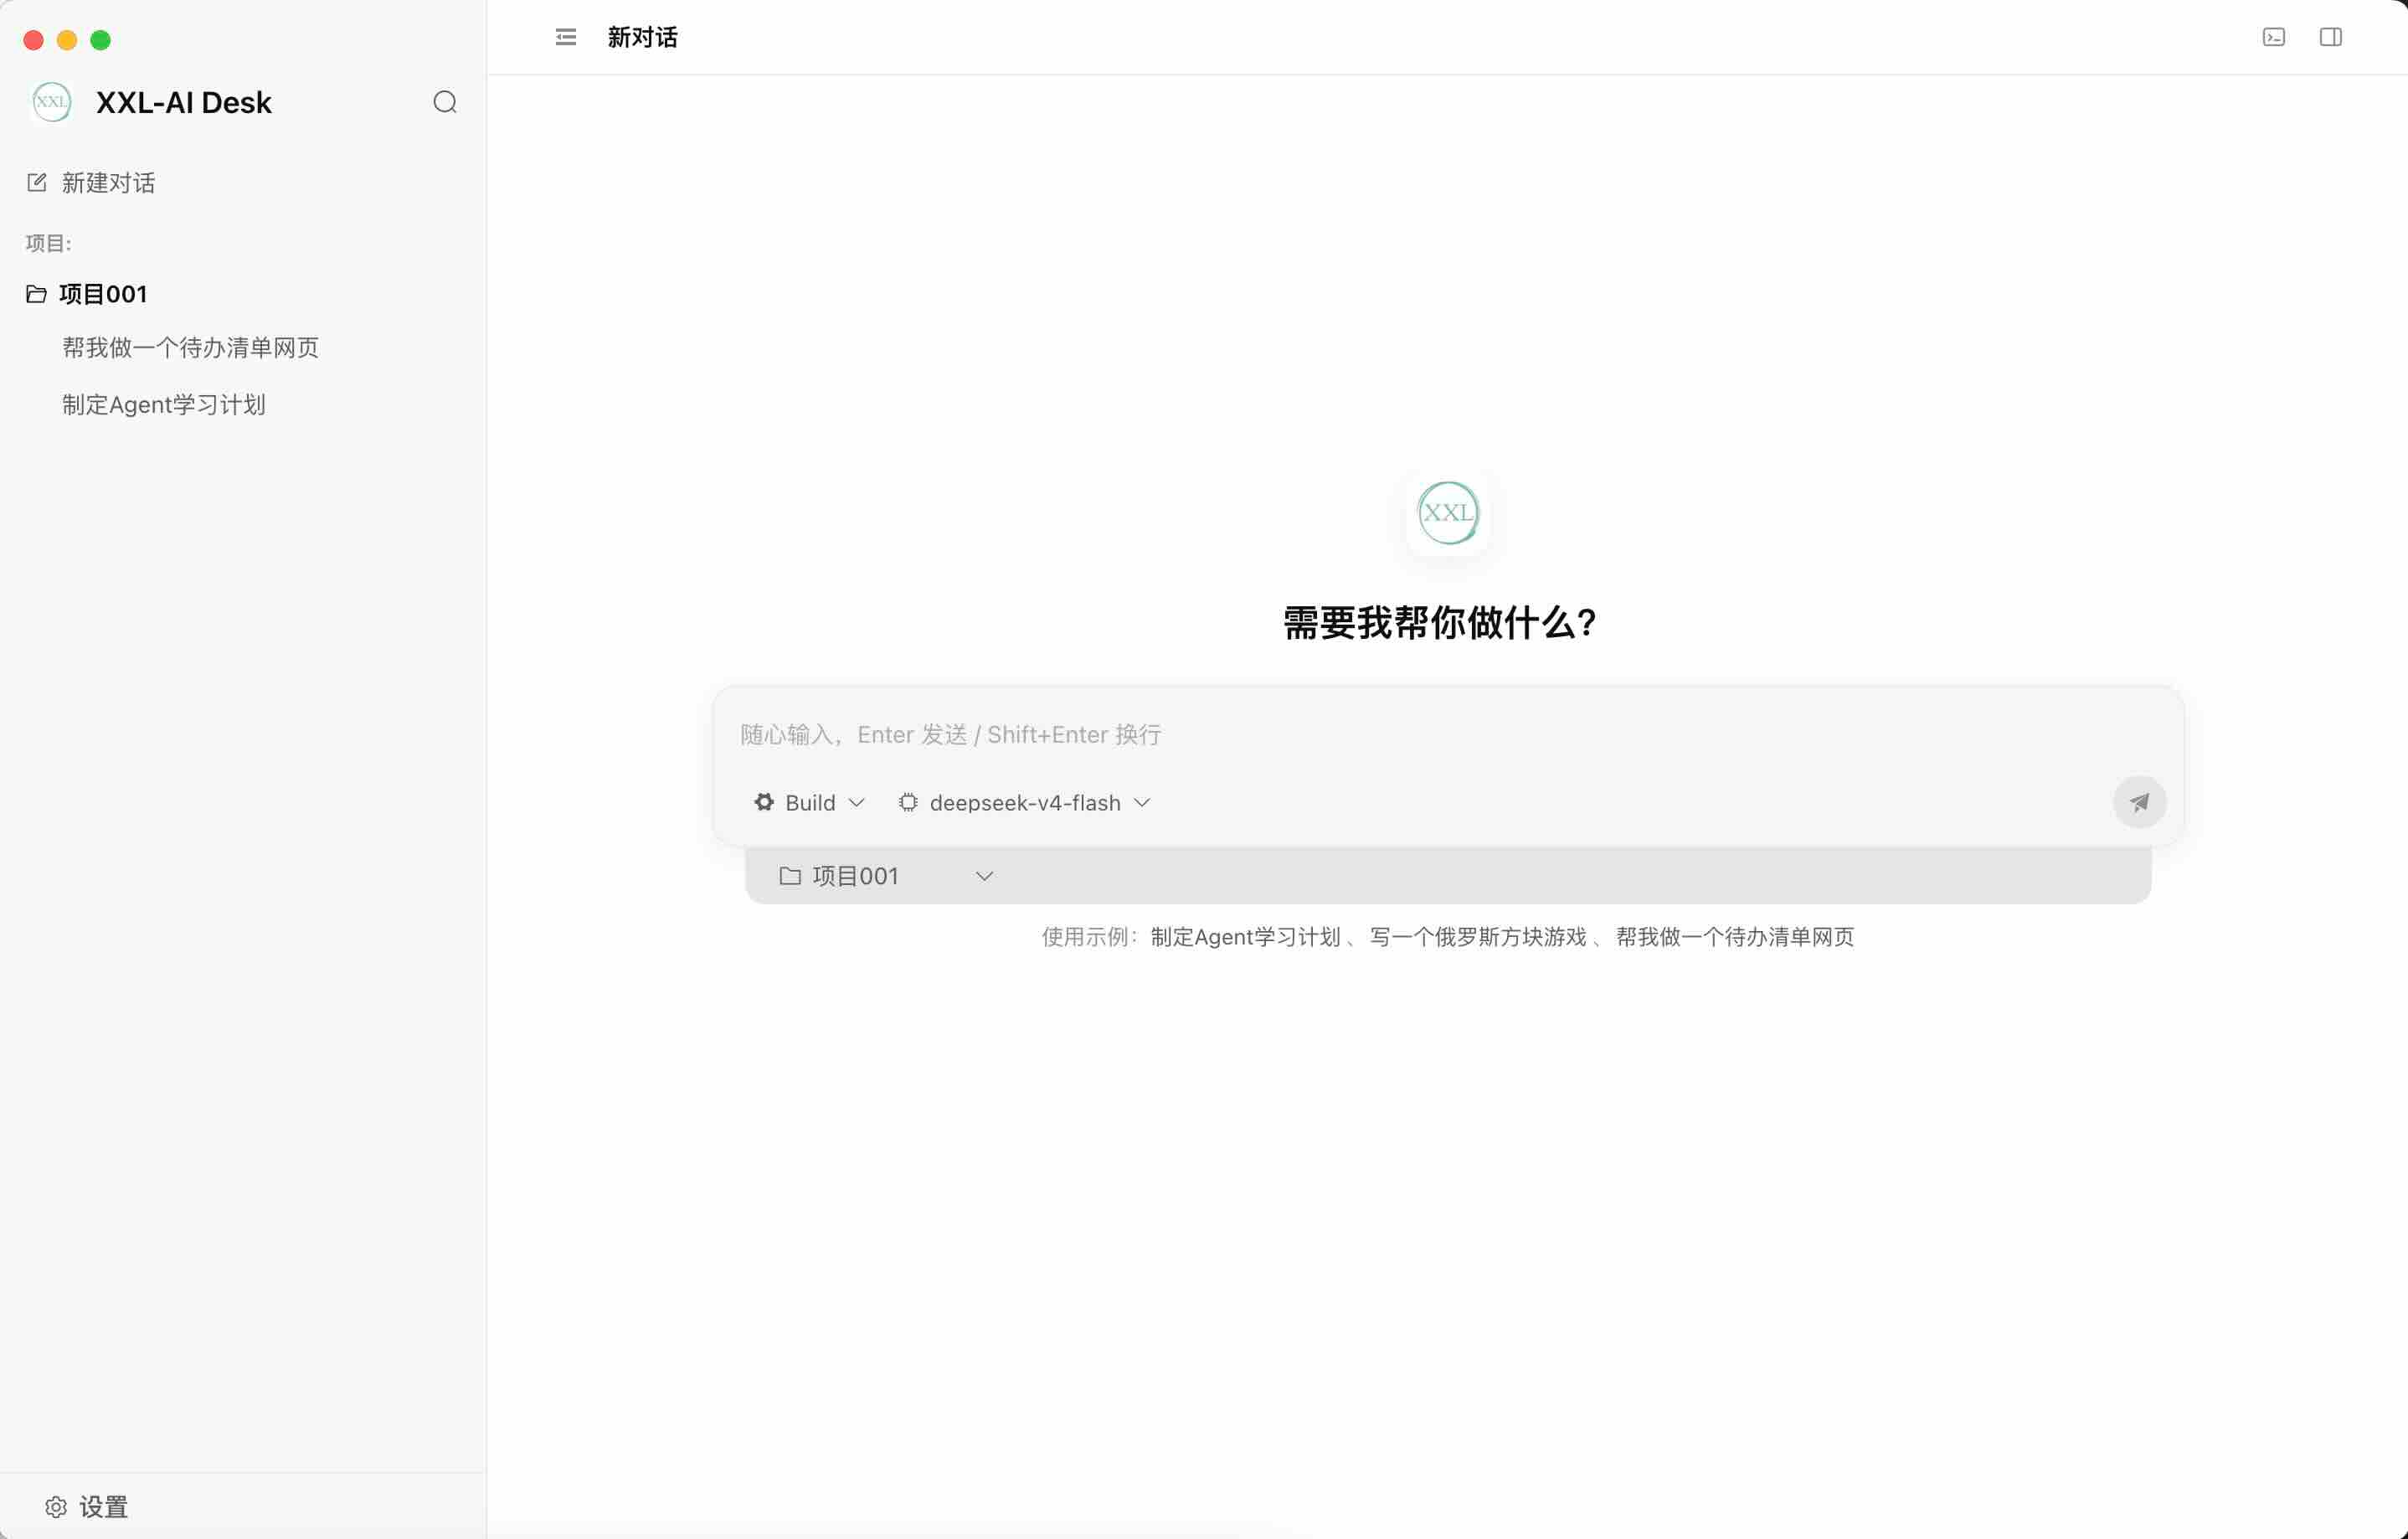
图:Desk 界面总览:会话栏 + 对话区 + 右侧工具面板(图片来源:XXL-AI 官方文档)
按官方教程的界面划分:左侧会话栏(可折叠为窄图标栏,按项目分组,底部为新建对话/设置/折叠),中间内容区(顶栏标题与模型切换、消息流、Composer 输入框与底部会话状态信息条),右侧工具面板(文件 / Git / 终端 / 浏览器统一为 Tab,可放大占满正文区、拖拽宽度、按会话隔离)。新建对话时输入框下方必须选择项目与 Agent,并提供示例任务快速上手。
5.2 能力收敛:三种扩展归一为 AgentTool
v1.5.0 把"插件中心"改名扩展中心,四个子页:Agent / MCP / SKILL / 内置工具。其中 Agent 是能力编排实体,新建会话必须选项目 + Agent(desk_session.agent_id)。MCP、SKILL、内置工具形态各异,但最终都归一为 Pi 的 AgentTool 装配进同一会话 Agent:
| 维度 | MCP | SKILL | 内置工具 |
|---|---|---|---|
| 形态 | 外部服务(HTTP / 子进程) | 目录 + SKILL.md |
编译期内置函数 |
| 暴露给模型 | 每个工具一个 mcp_{服务}_{工具} |
一个 read_skill + 系统提示中的技能索引 |
每个工具一个(read_file / run_command …) |
| 权限过滤 | 只读档仅放行 readOnlyHint===true |
只读工具三档均可用 | 按 ToolMeta.permissionModes |
| 变更生效 | 保存/删除后 resetAgents |
导入/启停后 resetAgents |
Agent 保存后下一轮重建 |
提示词经济是这里的关键词:常驻上下文只放索引,正文按需拉取。内置工具清单经 buildToolGuide() 生成「名称(只读/可写):说明」追加到系统指令,避免模型臆造工具;SKILL 只注入名称与描述,正文由 read_skill 按需读取(输出上限 100k 字符);MCP 靠工具自身的 name/description/inputSchema,不额外注入。这正是对齐 Anthropic Skills 渐进式披露的做法。
装配时序:chatService.sendChat 产出只读运行时配置(项目目录作沙箱根、Agent 指令、skillIds/mcpIds 过滤后的列表、长期记忆)→ runtimeHost → session.createAgent → new Agent({ initialState: { systemPrompt, model, thinkingLevel, tools }, streamFn, ...createTraceHooks() })。MCP 发现给 2s 预算(MCP_DISCOVERY_BUDGET=2000),未就绪不阻塞首字,就绪后直接补进 agent.state.tools。
5.3 三层闸门与三档权限
「权限即边界」的含义是:从工具装配与路径闸门两层限制副作用,而不是靠提示词约束模型自觉。
| 档位 | 语义 | 工具装配 |
|---|---|---|
read-only 仅可查看 |
全局可读 | 不装配写/命令工具,MCP 只注册服务端声明为只读的工具 |
workspace-write 工作区内修改(默认) |
全局读 + 项目目录/系统临时目录写 | 装配写与命令工具,越界转审批 |
full-access 完全权限 |
全局读写 | 全量放开,敏感目录仍兜底拦截 |
三道闸门相互独立:权限闸门(按 permissionModes 过滤工具集)→ 路径闸门(所有文件工具统一 guardPath)→ 拦截闸门(危险命令与敏感路径直接拒绝,不请求审批)。
sandbox.ts 的 guardPath 短路顺序:读取一律放行 → read-only 拒写 → 技能库可信根放行 → protectedPathOf 敏感路径兜底 → withinWriteScope(项目根 / full-access / 临时目录)→ 会话级信任 → 发 interaction-request 审批。路径规范化 canonicalize() 会逐级回落到最近的已存在祖先再 realpath,把软链接与 .. 全部摊平,isWithinRoot 用 startsWith(root + sep) 防前缀穿越。
敏感路径黑名单:Windows %SystemRoot% / %ProgramFiles% / %ProgramData%;POSIX /etc /usr /bin /sbin /boot /System /Library;通用 ~/.ssh ~/.aws ~/.gnupg ~/.kube ~/.netrc ~/.git-credentials。危险命令规则库 8 条正则:递归删根/家目录、mkfs/dd of=/dev/、关机重启、chmod 777 /、sudo、覆盖系统目录、curl|sh 下载管道执行、fork 炸弹;命中即把原因回填给模型并拒绝执行。run_command 默认 60s 超时、maxBuffer 2 MB、输出再截到 20k、executionMode: 'sequential'。
人机交互分两类,都在输入框位置内联展示、不用全局模态弹窗:被动审批(「允许本次 / 本会话允许 / 拒绝」,会话级信任仅存内存、重启失效)与主动询问(ask_user,每问题 2~20 选项、一次 1~10 题、界面显示 1/N)。交互队列按会话隔离,非当前会话的请求不抢占输入区。
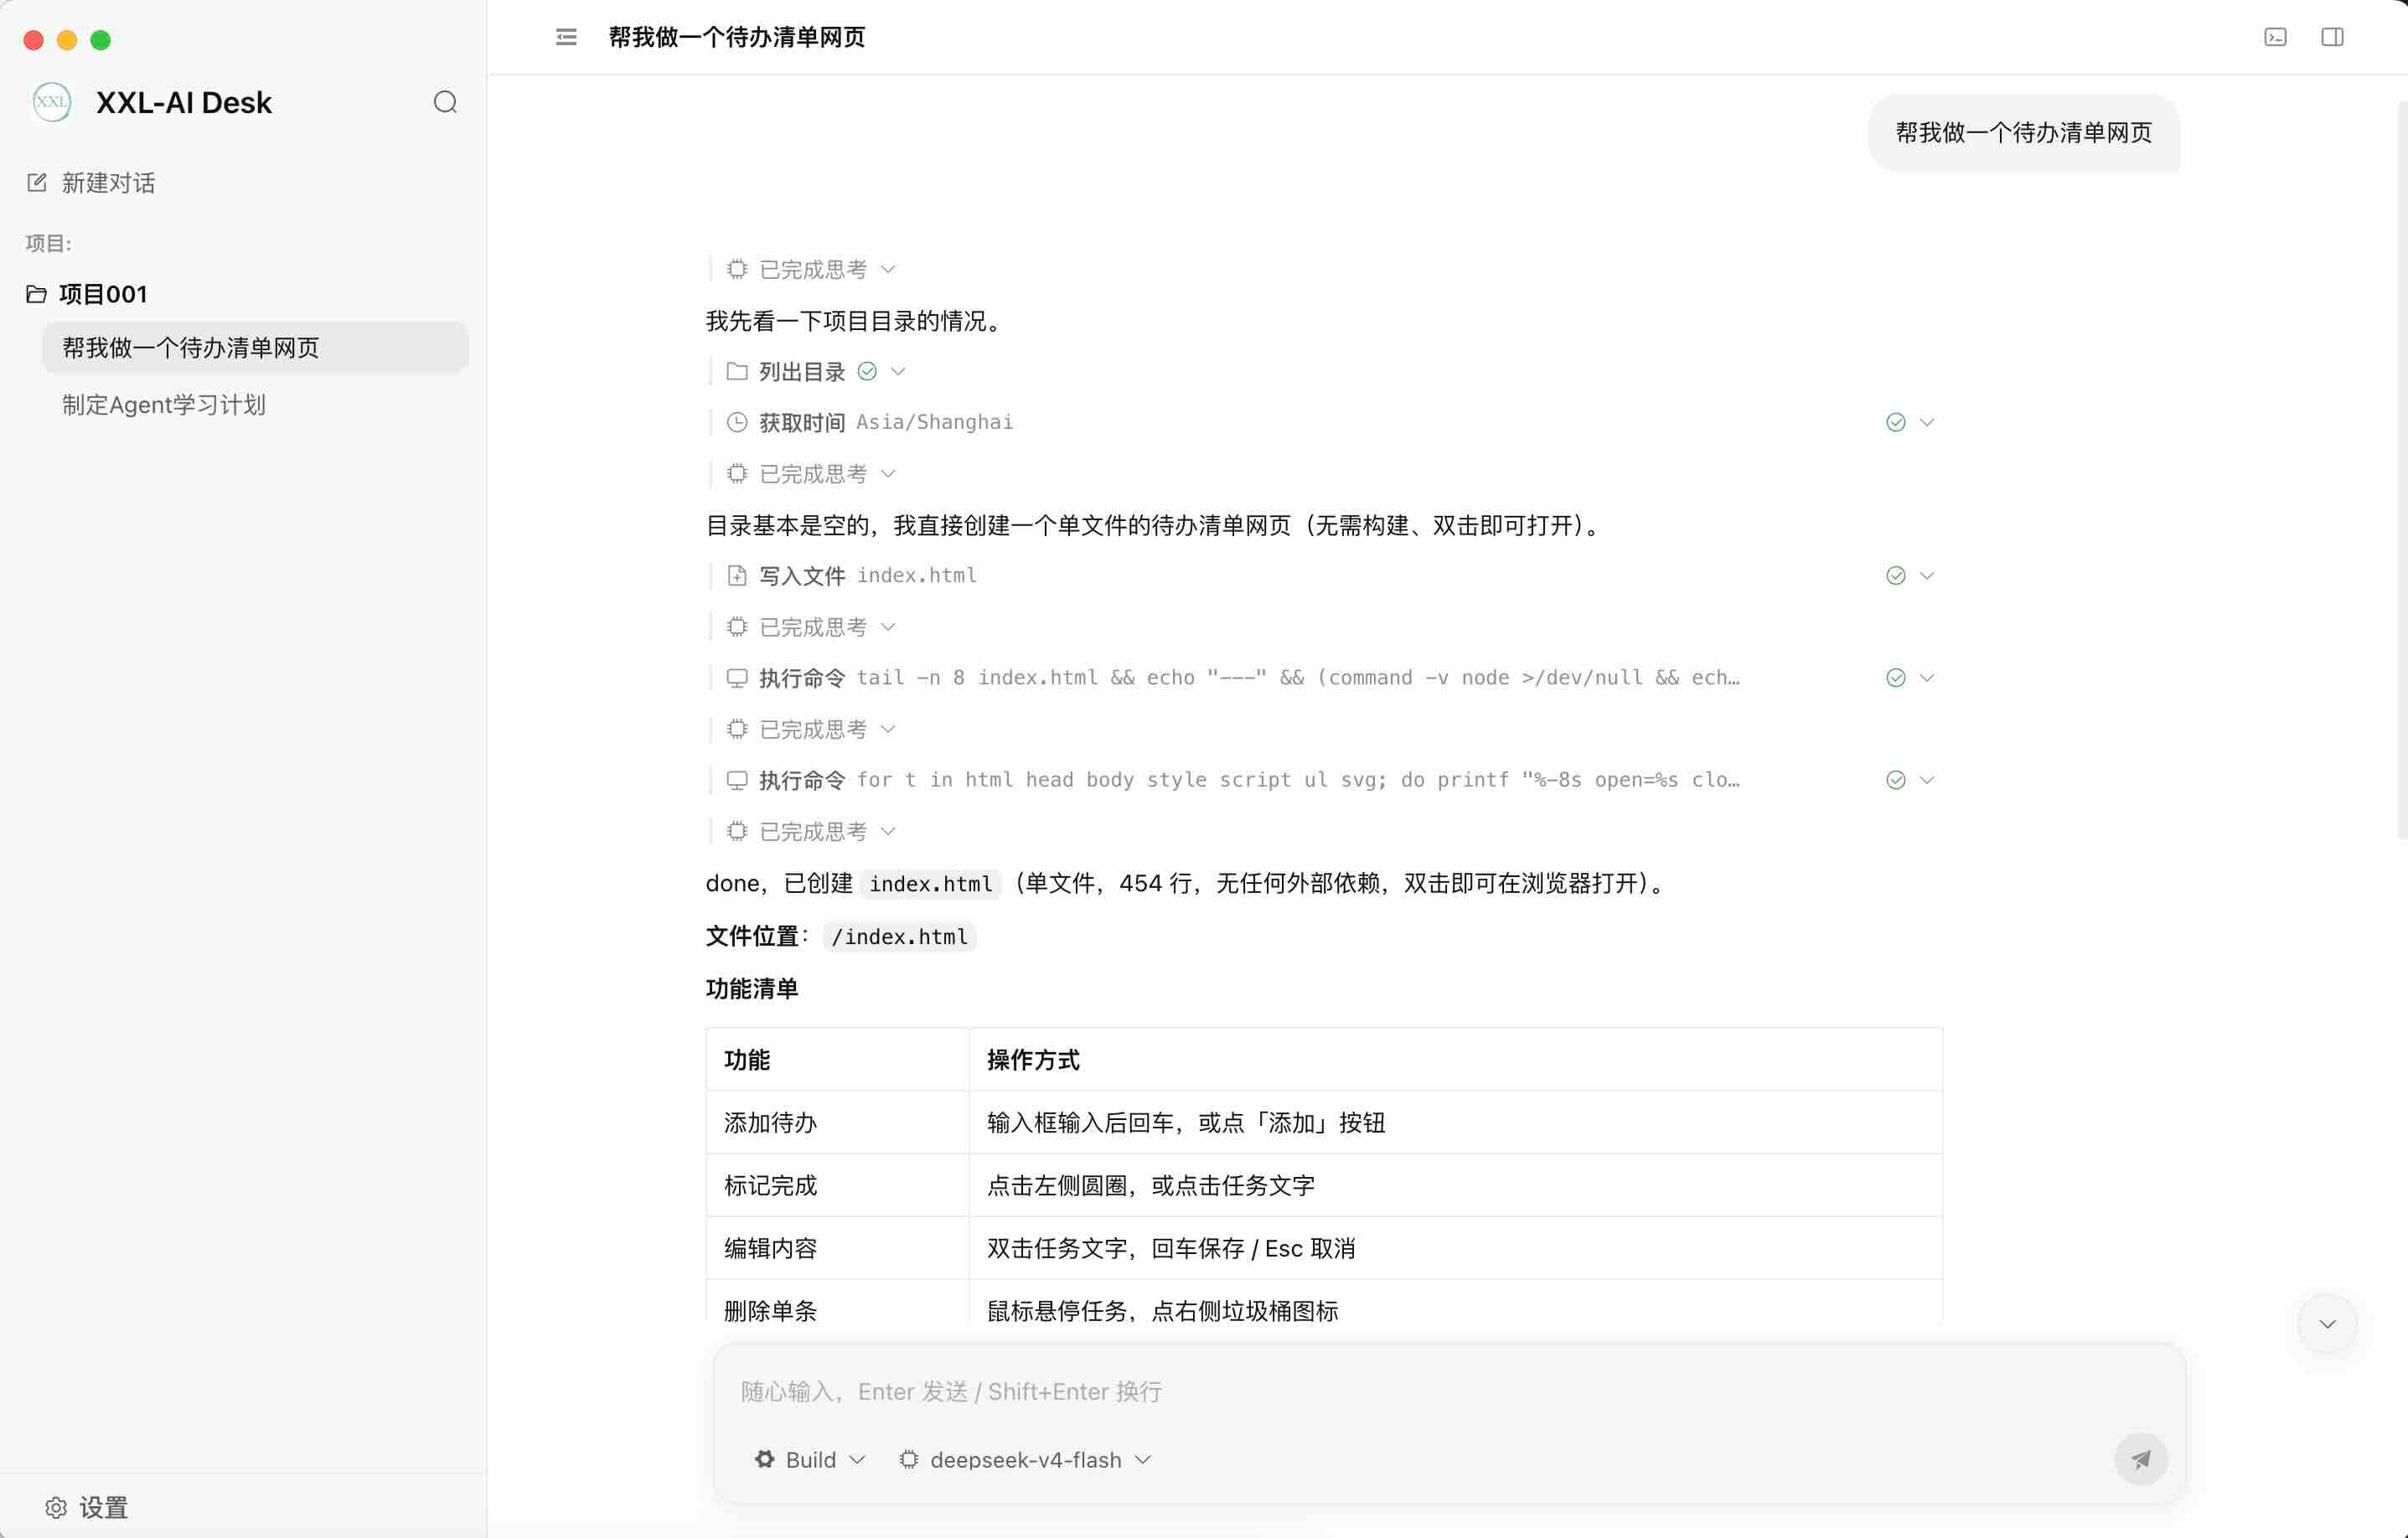
图:Desk 对话与权限模式:思考 / 工具 / 正文时间线渲染(图片来源:XXL-AI 官方文档)
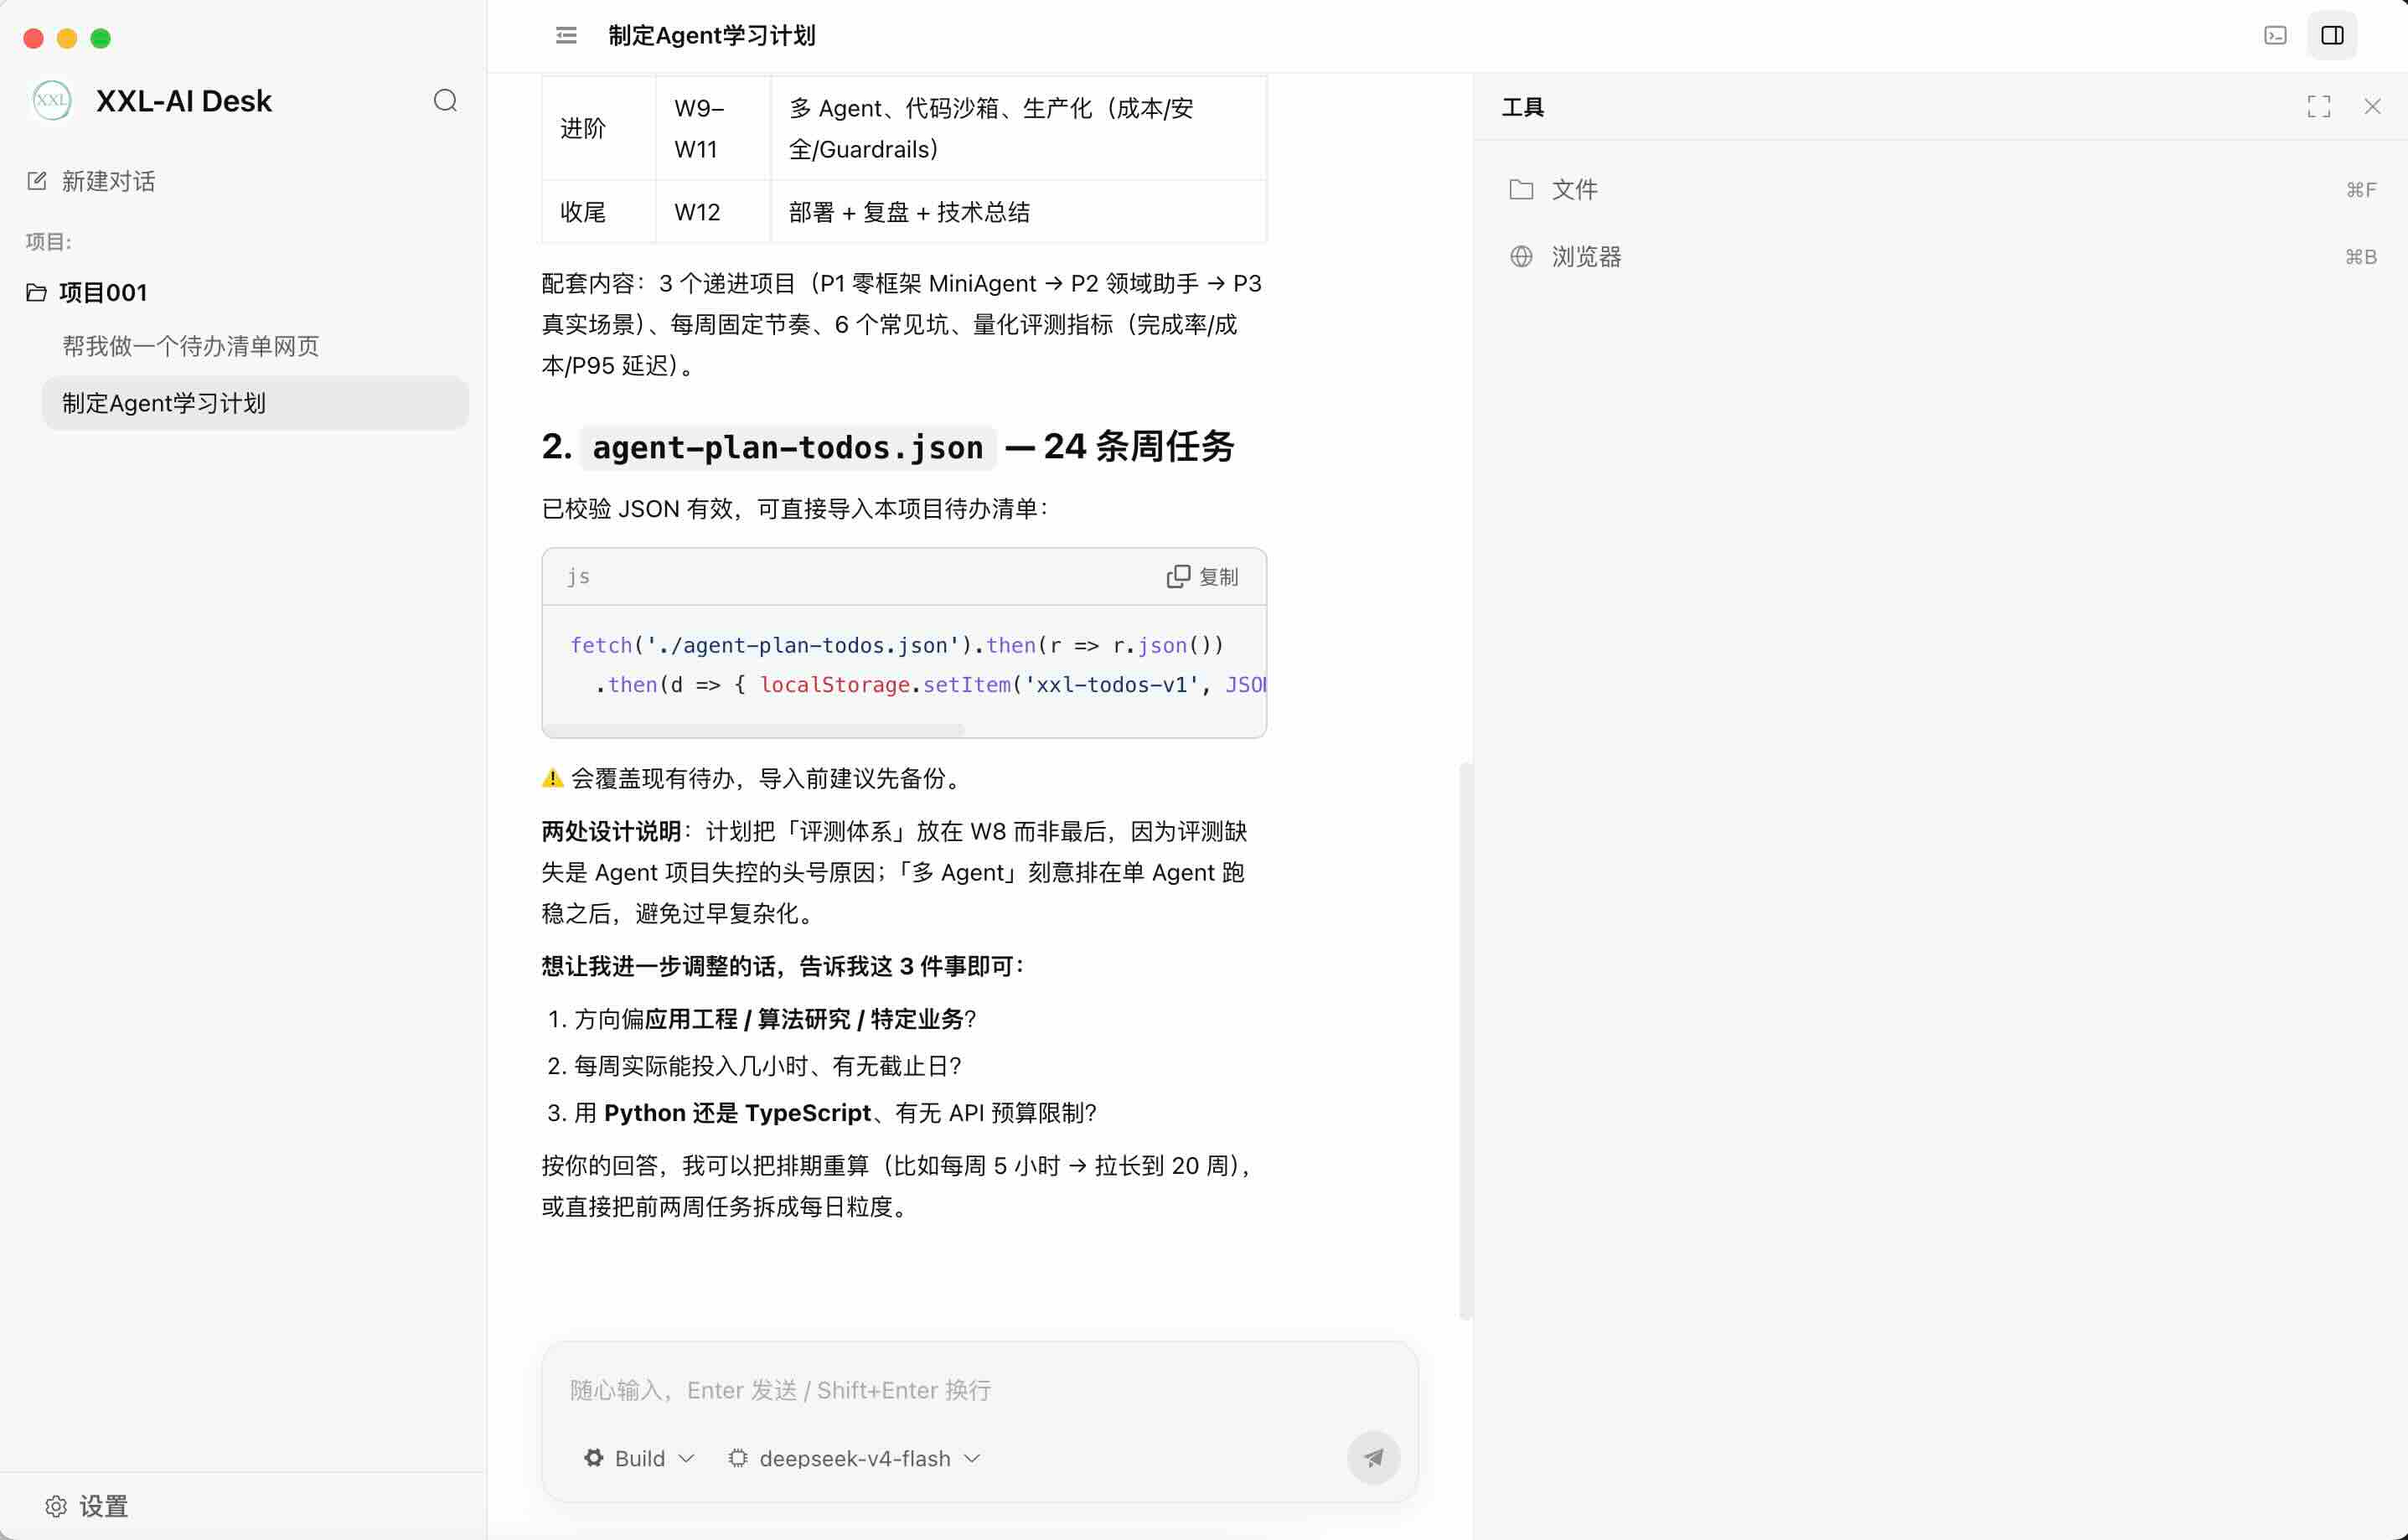
图:Desk 工具面板:文件 / Git / 终端 / 浏览器统一 Tab(图片来源:XXL-AI 官方文档)
官方教程补充的可观测细节:助手消息按片段发生顺序渲染时间线(思考 → 工具 → 正文交错),思考运行中实时展开、完成后收起;工具调用独立成行,展示动作、参数、状态与耗时,点击可展开入参/结果;轮次结束给出耗时摘要,代码块为 GitHub 风格(语言标签 + 复制 + 语法高亮)。工具面板 Tab 顺序为文件 → Git → 终端 → 浏览器,开启开发者模式后追加「诊断」Tab。
5.4 会话压缩与长期记忆(Desk 版)
同样遵循"生成与消费解耦",但拆成两层:
| 项 | 会话压缩(会话内) | 长期记忆(项目级) |
|---|---|---|
| 存储 | desk_session.summary / summary_last_message_id |
随 desk_project 行保存 memory / memory_last_time |
| 触发(每轮结束异步) | 无摘要 或 上下文使用率 ≥ 80% 或 真实用户轮次 ≥ 20 | 记忆为空 或 距上次生成 > 5 分钟,且游标后有新消息 |
| 转录 | 只取 user/assistant 正文,排除 thinking 与工具结果,上限 60k 字符 | 同 60k,按项目下多会话分节「## 会话:标题」 |
| 输出章节 | 背景与约束 / 目标 / 关键决策 / 进展与产物 / 待办与风险(5 个) | 用户偏好 / 项目事实 / 关键决策 / 待办与风险(4 个) |
| 上限 | 2000 字符 | 2000 字符 |
| 模型参数 | temperature=0.2、maxTokens=3000、timeoutMs=120000 |
同左 |
| 生效 | 成功后 evictAgent(sessionId),下一轮重建 |
成功后 evictProjectSessions() |
为什么长期记忆游标用时间而不是消息 ID?因为
desk_message.id是会话内自增序号,无法跨会话累计;只有memory_last_time(ISO 时间)才能覆盖项目下全部会话。这个细节很能体现作者对本地数据模型的清醒认识。
5.5 可观测与本地数据
开发者模式(默认关闭)下采集 desk_llm_trace,一次模型 HTTP 请求 = 一条记录,同一轮 run_id 串联、step 递增——按请求记而非按 run 记,才能还原工具循环中间过程"模型看到了什么、返回了什么、调了哪些工具"。采集在唯一能看到 provider payload 的 worker 进程,parentPort.postMessage({type:'llm-trace'}) 回主进程落库,fire-and-forget,落库失败只记日志不阻断对话。
SQLite 共 10 张表(desk_provider / project / session / message / setting / skill / mcp / agent / llm_trace / app_setting),journal_mode=WAL,DDL 按 9 个片段组合根拼接。默认数据文件在 app.getPath('userData')/xxl-ai-desk.sqlite,可在设置里改(写 userData/desk-config.json,重启生效)。
六、设计思路提炼:七条贯穿全项目的工程原则
- 生成与传输解耦:Redis Stream 把 LLM 生成从 SSE 连接里择出来,换来集群化与断点续传(云版);
utilityProcess把 Agent 循环从 UI 主线程里择出来,换来长任务不卡界面(本地版)。 - 降级优先,辅助能力永不阻塞主流程:记忆注入失败降级、单库 RAG 失败跳过并写思考流、MCP 单服务失败跳过、trace 落库失败只记日志、失败/终止都回填已生成的部分内容。
- 指纹即缓存失效策略:SHA-256 配置指纹统一驱动模型、向量存储、MCP 客户端的重建;
id:updateTime指纹驱动技能目录重建;5min LRU 兜底过期。不用在业务代码里到处evict()。 - 索引常驻、正文按需:SKILL 渐进式披露、工具清单注入而非全量文档,控制常驻上下文成本。
- 权限即边界:不靠提示词劝模型守规矩,靠"不装配工具 + 路径闸门 + 硬拦截"三层机械约束。
- 单包部署优先:前端产物内嵌 jar、Hash 路由免回退、Compose 一键起全栈,把运维门槛压到最低。
- AI + SKILL 自举:仓库自带
.agents/skills/xxl-ai/SKILL.md(云版)与xxl-ai-desk/SKILL.md(Desk 版)两份"项目内专业规范",AI 编程助手加载后按「建表 → 后端 → 前端 → 菜单权限 → 验证」直生代码并落位,AGENTS.md再约束 DRY(第三次再抽象)、KISS、精确版本、中英文案成对提交。代码生成器已下线,改为用 Skill 约束 AI 产出等价代码——这是 2026 年很有代表性的一种工程实践。
七、技术优点:把上面的分析收敛成一张表
| 优点 | 代码落点 | 实际收益 |
|---|---|---|
| 真正可集群的流式对话 | ChatStreamTool + Redis Stream 消费组 |
无粘性会话、节点重启不丢生成、刷新续传,这在同类开源平台里并不常见 |
| Java/Spring 团队零语言切换 | SpringBoot 4 + spring-ai 2 + MyBatis | 存量 Java 中后台团队无需引入 Python 侧车,可直接复用现有 MySQL/Redis 运维体系 |
| 开箱即用的企业治理底座 | XXL-SSO + 枚举 RBAC + space_id + 审计日志 |
登录态集中、菜单按钮级权限、多业务空间隔离,是社区版 Dify 一类产品常见的缺口 |
| 三件套对齐开放规范 | MCP 2.1.0 SDK(Streamable HTTP / stdio)、SKILL.md、Milvus RAG |
不绑定自家插件格式,外部生态工具可直接接入 |
| 一键发布闭环 | uuid + 免登录 /#/chat/{uuid} + 访客会话回看 |
「编排 → 分享」一步完成,无需另配渠道或 API 网关 |
| 绑定与装配分离 | xxl_ai_agent 逗号分隔 ID 串 + harness 运行时装配 |
加一类资源不改 Agent 表结构,配置变更下一轮即生效 |
| 降级设计密度高 | 记忆 / RAG / MCP / trace / 任务投递全链路 | 外部依赖抖动时对话主流程仍可用,生产可用性更好 |
| 双形态覆盖两类场景 | 云版平台治理 + Desk 本地工作台 | 团队统一平台与个人本地编码互不牵扯,各自闭环 |
| 运维 simplicity | sync:dist 内嵌 jar、Hash 路由、Compose 全栈 |
一个 java -jar 就能起完整平台,无需 Nginx |
| 代码结构清晰、易于二开 | business/harness 硬边界、模块自包含、两份开发 SKILL |
二开时能明确"代码该落在哪",产出也符合平台规范 |
八、代码级观察:文档与实现的偏差,以及真实局限
这一节是选型时最该先看的部分。先说清楚:以下不是"挑错",而是一个 6 周迭代 8 个版本的项目必然存在的文档滞后,以及有意为之的工程取舍。
8.1 文档与代码的三处实质差异,加一处文档未明说的补充
| 项 | 官方文档 | 源码实际 |
|---|---|---|
| Redis Stream key(补充) | 只说明「助手占位主键 msgId 同时作为结果流标识」,未给出具体 key 命名 |
任务队列 xxl:ai:chat:tasks、消费组 default-group、结果流 xxl:ai:chat:result:{msgId}、归档锁 xxl:ai:memory:archive:lock |
/chat/send 参数 |
POST /chat/send?uuid&visitorId&convId&content |
@RequestBody ChatSendDTO,字段为 sessionId 而非 convId;另有文档未列的 POST /chat/stop |
| Desk 的 MCP 装配握手超时 | 120s,显式测试 30s | ASSEMBLY_CONNECT_TIMEOUT = 300000(300s);stdio 连通测试同为 300s,仅远程 HTTP 为 30s;主进程另有 6 分钟 IPC 总超时 |
| Desk 的 API Key 存储 | 「经 securityService 编解码后入库(不落明文)」 | securityService.ts 只有 Buffer.from(plain).toString('base64') / 反向解码,base64 等同明文,未用 Electron safeStorage 或系统钥匙串 |
补充两处文档未列的细节:Desk 的 webPreferences 实际还带 sandbox: false 与 webviewTag: true;SKILL 的 YAML frontmatter 解析发生在主进程导入期(skill/main/import.ts#parseSkillMeta),worker 侧 read_skill 返回文件原文(含 --- 头),100k 截断由 agent/worker/tools/index.ts#clipToolResult 统一执行。
安全提示:如果你要把 Desk 版用于存放高价值 API Key 的机器,第 4 条值得单独处理——把
securityService.ts换成safeStorage.encryptString()/decryptString()是一个很小的改动,但收益明显。
8.2 需要如实告知的局限
POST /chat/stop只终止本节点生成。终止依赖ChatStreamTool内的本地ConcurrentHashMap<Long, RunContext> runContexts,ChatServiceImpl.stop()的注释也写明"主动终止本节点会话进行中的生成"。集群下若请求节点与 worker 不是同一节点,终止信号无法跨节点传递。这是"无状态化"设计留的一个尾巴:生成与转发解耦了,但终止控制面还是节点本地的。改造方向是把cancel做成 Redis Pub/Sub 广播或按sessionId写一个分布式标记。- RAG 能力偏基础:只有字符级滑窗分片、txt/md 文档、纯向量检索,没有 PDF/Word/图片解析、没有 BM25 混合检索与 rerank、没有引用溯源。TODO LIST 里明确列着这些。
- 没有可视化工作流编排:Agent 是"配置式组合"而非 DAG,做不了分支、循环、并行、条件路由。TODO LIST 第一条就是 “WorkFlow 定义”。需要复杂流程编排的场景,Dify / Langflow / n8n 更合适。
- 云版尚无 OpenAPI 与可观测:
agentId + accessToken的 OpenAPI、Session/工具/知识/记忆 Trace 明细都在 TODO LIST 里。目前可观测只在 Desk 版(开发者模式)。 - 公开端免登录 = 需要自己做防护:
/chat/**全部@XxlSso(login = false),只靠一个 UUID 与visitorId隔离。对外发布时应自行在网关层加限流、鉴权与内容审计。 - GPLv3 的传染性:做多租户 SaaS 或白标交付没有 Dify 式附加条款阻碍,但 GPLv3 要求衍生作品同样以 GPLv3 开源;若计划闭源二开商业分发,需要先评估合规路径。
- 技能物化目录是本地路径:集群部署建议共享持久卷,否则节点间技能生效时机可能不一致。
- 记忆 2000 字符上限:「近期进展」会不断覆盖旧内容,本质是滚动窗口式遗忘,属有意取舍而非 bug;但别指望它做长期事实库。
- 逗号分隔 ID 串无外键:
VARCHAR(500)有上限、删除资源需应用层清理残留、跨表一致性靠代码保证。
✗ 别把它当成"Dify 的 Java 平替":工作流编排、文档解析、插件市场、评测体系都还不在能力范围内。
✓ 把它当成"AI Agent 化的 Java 中后台脚手架":登录、权限、多租户、审计、集群流式、部署运维这些脏活已经替你做完了,你在这个底座上长自己的 Agent 应用。
九、与现有产品对比:它到底站在哪个生态位
9.1 先厘清两个时间坐标
对比之前有两个事实容易写错,这里按官方来源校准:
- MCP 由 Anthropic 于 2024 年 11 月开源发布,首个规范版本记作
2024-11-05,远程传输原为 HTTP+SSE;2025-03-26 修订明确 “Replaced the previous HTTP+SSE transport with a more flexible Streamable HTTP transport”,同时加入 OAuth 2.1 授权框架、JSON-RPC batching 与 tool annotations。也就是说 XXL-AI 支持的 Streamable HTTP 是现行推荐传输,不是遗留兼容。 - Agent Skills /
SKILL.md由 Anthropic 于 2025 年下半年作为开放标准推出,核心是"一个含SKILL.md的目录 + 渐进式披露"。XXL-AI 云版与 Desk 版都跟进了这套规范,Desk 版还接入 skills.sh 与 GitHub 安装。
9.2 四类玩家,各比各的
把市面上的产品按生态位分四类,比混在一张表里更有意义:
A. LLM 应用 / Agent 平台(与云版直接竞争)
| 产品 | 定位 | 技术栈 | 协议与关键限制 |
|---|---|---|---|
| XXL-AI 云版 | Java 中后台式 Agent 平台,重治理与发布 | SpringBoot 4 / Vue3 / MySQL+Redis+Milvus | GPLv3,无附加商业条款 |
| Dify | 一站式 LLM 应用开发平台,可视化工作流 + RAG + Agent | Python(Celery / Gunicorn)、Next.js、PostgreSQL+Redis、可插拔向量库 | Apache 2.0 修改版:未经书面授权不得运营多租户环境(一个 workspace 算一个租户),使用其前端时不得移除/修改 LOGO 与版权信息 |
| Coze Studio(开源版) | 低代码 Agent / 工作流平台 | Go(Eino / Hertz)+ React + TS,微服务 + DDD | Apache 2.0,无附加条款;云版 Coze 为闭源 SaaS |
| Langflow | 可视化 Agent / RAG 构建器,可导出为 MCP Server | Python(FastAPI + LangChain)+ React Flow | MIT,宽松 |
| FastGPT | 知识库问答为核心的智能体平台 | Next.js + MongoDB / pgvector / Milvus | Apache 2.0 + 附加条款:禁运营类似多租户 SaaS、禁移除控制台 LOGO 与版权 |
| RAGFlow | 深度文档理解型 RAG 引擎 | 官方仓库以容器化多组件栈交付,ES / Infinity + MySQL + Redis + MinIO | Apache 2.0 |
| n8n | 工作流自动化 + AI Agent | Node.js / TypeScript monorepo,Vue3,SQLite/PostgreSQL | Sustainable Use License(fair-code,非 OSI 认证开源):禁作为托管服务转售、禁让外部用户自行搭建工作流 |
B. Java 生态的 Agent 框架(同源但不同层)
Spring AI Alibaba 与 AgentScope Java 都是 Apache 2.0 的 SDK / 框架(Graph 编排、多 Agent、MCP、HITL、沙箱),面向"我要自己写一个 Agent 应用"的 Java 开发者。XXL-AI 与它们同源(Spring AI 生态),但交付的是开箱即用的成品平台 + 管理后台 + 桌面端,不是库。二者是互补而非替代:甚至可以把 XXL-AI 的 harness 层替换成更重的 Graph 运行时。
C. 桌面 AI 客户端(与 Desk 版形似)
Cherry Studio(Electron,AGPL-3.0)与 LobeChat(Next.js,Apache 2.0 + 商业化补充条款)主打多模型对话、知识库、MCP、插件市场。它们没有本地项目沙箱、终端、Git 审核、三档写入权限——面向"和 AI 聊天",不是"让 AI 改我的代码库"。
D. 编码 Agent(与 Desk 版神似)
Claude Code / Cursor 这类工具直接读写本机文件、跑命令、改 Git,权限模式是核心设计(Claude Code 有 default / acceptEdits / plan / auto 等档位,规则按 deny → ask → allow 生效且 deny 在所有模式下生效;Cursor 有 Auto-review / Allowlist / Run Everything 并配合 permissions.json 与 sandbox 配置)。它们闭源、订阅制。XXL-AI Desk 的差异化在于:显式三档 + 会话持久化 + 输入框内联可视化审批 + 开发者模式 Trace,且模型供应商可自由换成任意 OpenAI 兼容端点。
9.3 十个维度的横向结论
| # | 维度 | XXL-AI 的相对位置 |
|---|---|---|
| 1 | 许可证自由度 | GPLv3 无附加条款,做多租户 / 白标的法律边界比 Dify、FastGPT、n8n、LobeChat 清晰;但 GPLv3 有传染性,闭源二开需评估 |
| 2 | 双形态交付 | 同时覆盖"团队 Web 平台"与"个人本地工作台",且互不依赖——Dify / Coze / FastGPT 只有服务端,Cherry Studio / LobeChat 只有客户端 |
| 3 | 技术栈 | 主流开源 LLM 平台多为 Python / Go / Node,它是少见的 Java/SpringBoot 成品平台,对存量 Java 团队迁移成本最低 |
| 4 | 企业治理 | SSO + RBAC + 多空间 + 审计 + 集群部署内置,这是社区版 Dify 公认的缺口,也是 Coze Studio 开源版留给商业版的能力 |
| 5 | 流式架构 | SSE + Redis Stream 无状态化,断点续传与水平扩展语义明确,多数平台仍与单机会话绑定 |
| 6 | 开放规范对齐 | 同时把 MCP(双传输)+ SKILL.md + Milvus RAG 作为一等公民装进 Agent 编排,且远程/本地 MCP 与技能目录均自动装配 |
| 7 | 发布路径 | 一键生成 UUID 免登录公开地址并回看访客会话,比"配渠道 / 调 API"短一截 |
| 8 | 供应商治理粒度 | 供应商/模型两级 + 连通测试 + 远程模型导入 + 对话/嵌入模型区分,多数平台只做到"填 API Key" |
| 9 | 本地操作与权限 | 项目 1:1 绑定目录 + 三层闸门 + 越界内联审批 + 文件/Git/终端/浏览器面板,可直接对标编码 Agent 的 permissions + sandbox 双层模型 |
| 10 | 运维与二开门槛 | 单 jar 单端口、Compose 一键、内置开发 SKILL,对比 Dify 的多容器栈 / Python 环境明显更轻 |
最突出的三个差异点:① Java 栈 + 企业治理底座(生态位几乎空白);② 云本双形态且各自闭环(不是同步,是两套产品);③ SSE 无状态化这个偏架构而非偏功能的实现。
它不擅长的三件事:复杂工作流编排、深度文档解析型 RAG、成熟的多租户 SaaS 运营配套(计费、配额、租户自助、OpenAPI、可观测仍在 TODO)。
十、上手教程:从零发布一个会调工具的 Agent
10.1 环境清单
| 组件 | 云版 | Desk 版 |
|---|---|---|
| JDK / Maven | 17+ / 3+ | 不需要 |
| Node.js | 22+(仅前端) | 内置 Node 运行时 |
| MySQL / Redis | 8.0+ / 7.0+ | 不需要 |
| Milvus | 2.6+(可选,RAG 才需要) | 不需要 |
| 存储 | xxl_ai 库 + Redis |
单文件 xxl-ai-desk.sqlite |
10.2 云版:三条部署路径
# ① 初始化数据库:执行 doc/db/tables_xxl_ai.sql
#    含中文 COMMENT,务必指定 utf8mb4,否则注释/种子数据乱码:
mysql --default-character-set=utf8mb4 -h127.0.0.1 -uroot -p xxl_ai < doc/db/tables_xxl_ai.sql

# ② 改配置 xxl-ai-api/src/main/resources/application.properties
#    datasource / redis / milvus 三段;端口默认 8080

# ③a 本地开发
cd xxl-ai-api && mvn spring-boot:run                  # 8080
cd xxl-ai-ui  && npm i && npm run dev                 # 3000,/api 代理到 8080
cd xxl-ai-sample && mvn spring-boot:run               # 8091,可选,示例 MCP

# ③b 生产单包
cd xxl-ai-ui && npm i && npm run build && npm run sync:dist && cd ..
mvn clean package -Dmaven.test.skip=true
java -jar xxl-ai-api/target/xxl-ai-api-*.jar          # 页面与接口同在 8080

# ③c Compose 全栈(先打包两个 Maven 模块!)
cd docker && cat .env && docker compose up -d --build
访问 http://localhost:8080,默认账号 admin/123456——生产环境第一件事就是改掉它。docker/.env 里的 MYSQL_PATH / REDIS_PATH / MILVUS_PATH 默认是 macOS 风格路径,Windows / Linux 需自行改成可写目录。
10.2.1 官方操作总览(补充)
官方教程以「从零跑通一个可对话的 Agent」为主线,把管理端操作收敛成八步,并给出依赖关系:
| 步骤 | 菜单入口 | 操作目标 | 关键产出 |
|---|---|---|---|
| 1 | 登录页 | 登录管理端 | 进入工作台 |
| 2 | 系统管理 → 业务空间 / 用户管理 | 划分空间并授权用户 | 空间隔离生效 |
| 3 | 供应商模型 → 供应商 / 模型 | 接入 OpenAI 兼容供应商 | 可用对话 / 嵌入模型 |
| 4 | MCP工具 | 接入远程 / 本地 MCP 服务 | 可被 Agent 调用的工具 |
| 5 | SKILL技能 | 沉淀领域知识与脚本 | 可被 Agent 执行的技能 |
| 6 | RAG知识库 | 文档向量化入库 | 可检索的知识上下文 |
| 7 | Agent管理 | 编排并发布 Agent | 公开访问 UUID |
| 8 | /#/chat/{uuid} |
访客免登录对话 | 流式问答 |
依赖关系:步骤 3 的「对话模型」是步骤 7 的必选项,「嵌入模型」是步骤 6 向量化的前提;步骤 4/5/6 产出的资源在步骤 7 中按需多选绑定。最小可用路径 = 1 → 3 → 7 → 8,MCP / SKILL / RAG 全部可选。
管理端地址:开发期 http://localhost:3000,合并部署 http://localhost:8080,默认账号 admin/123456;验证码开关由系统配置 system.login.captcha.enabled 控制。登录后工作台聚合 Agent 数、SKILL 数、MCP 数、供应商模型数,并提供会话消息趋势 / 占比图表。
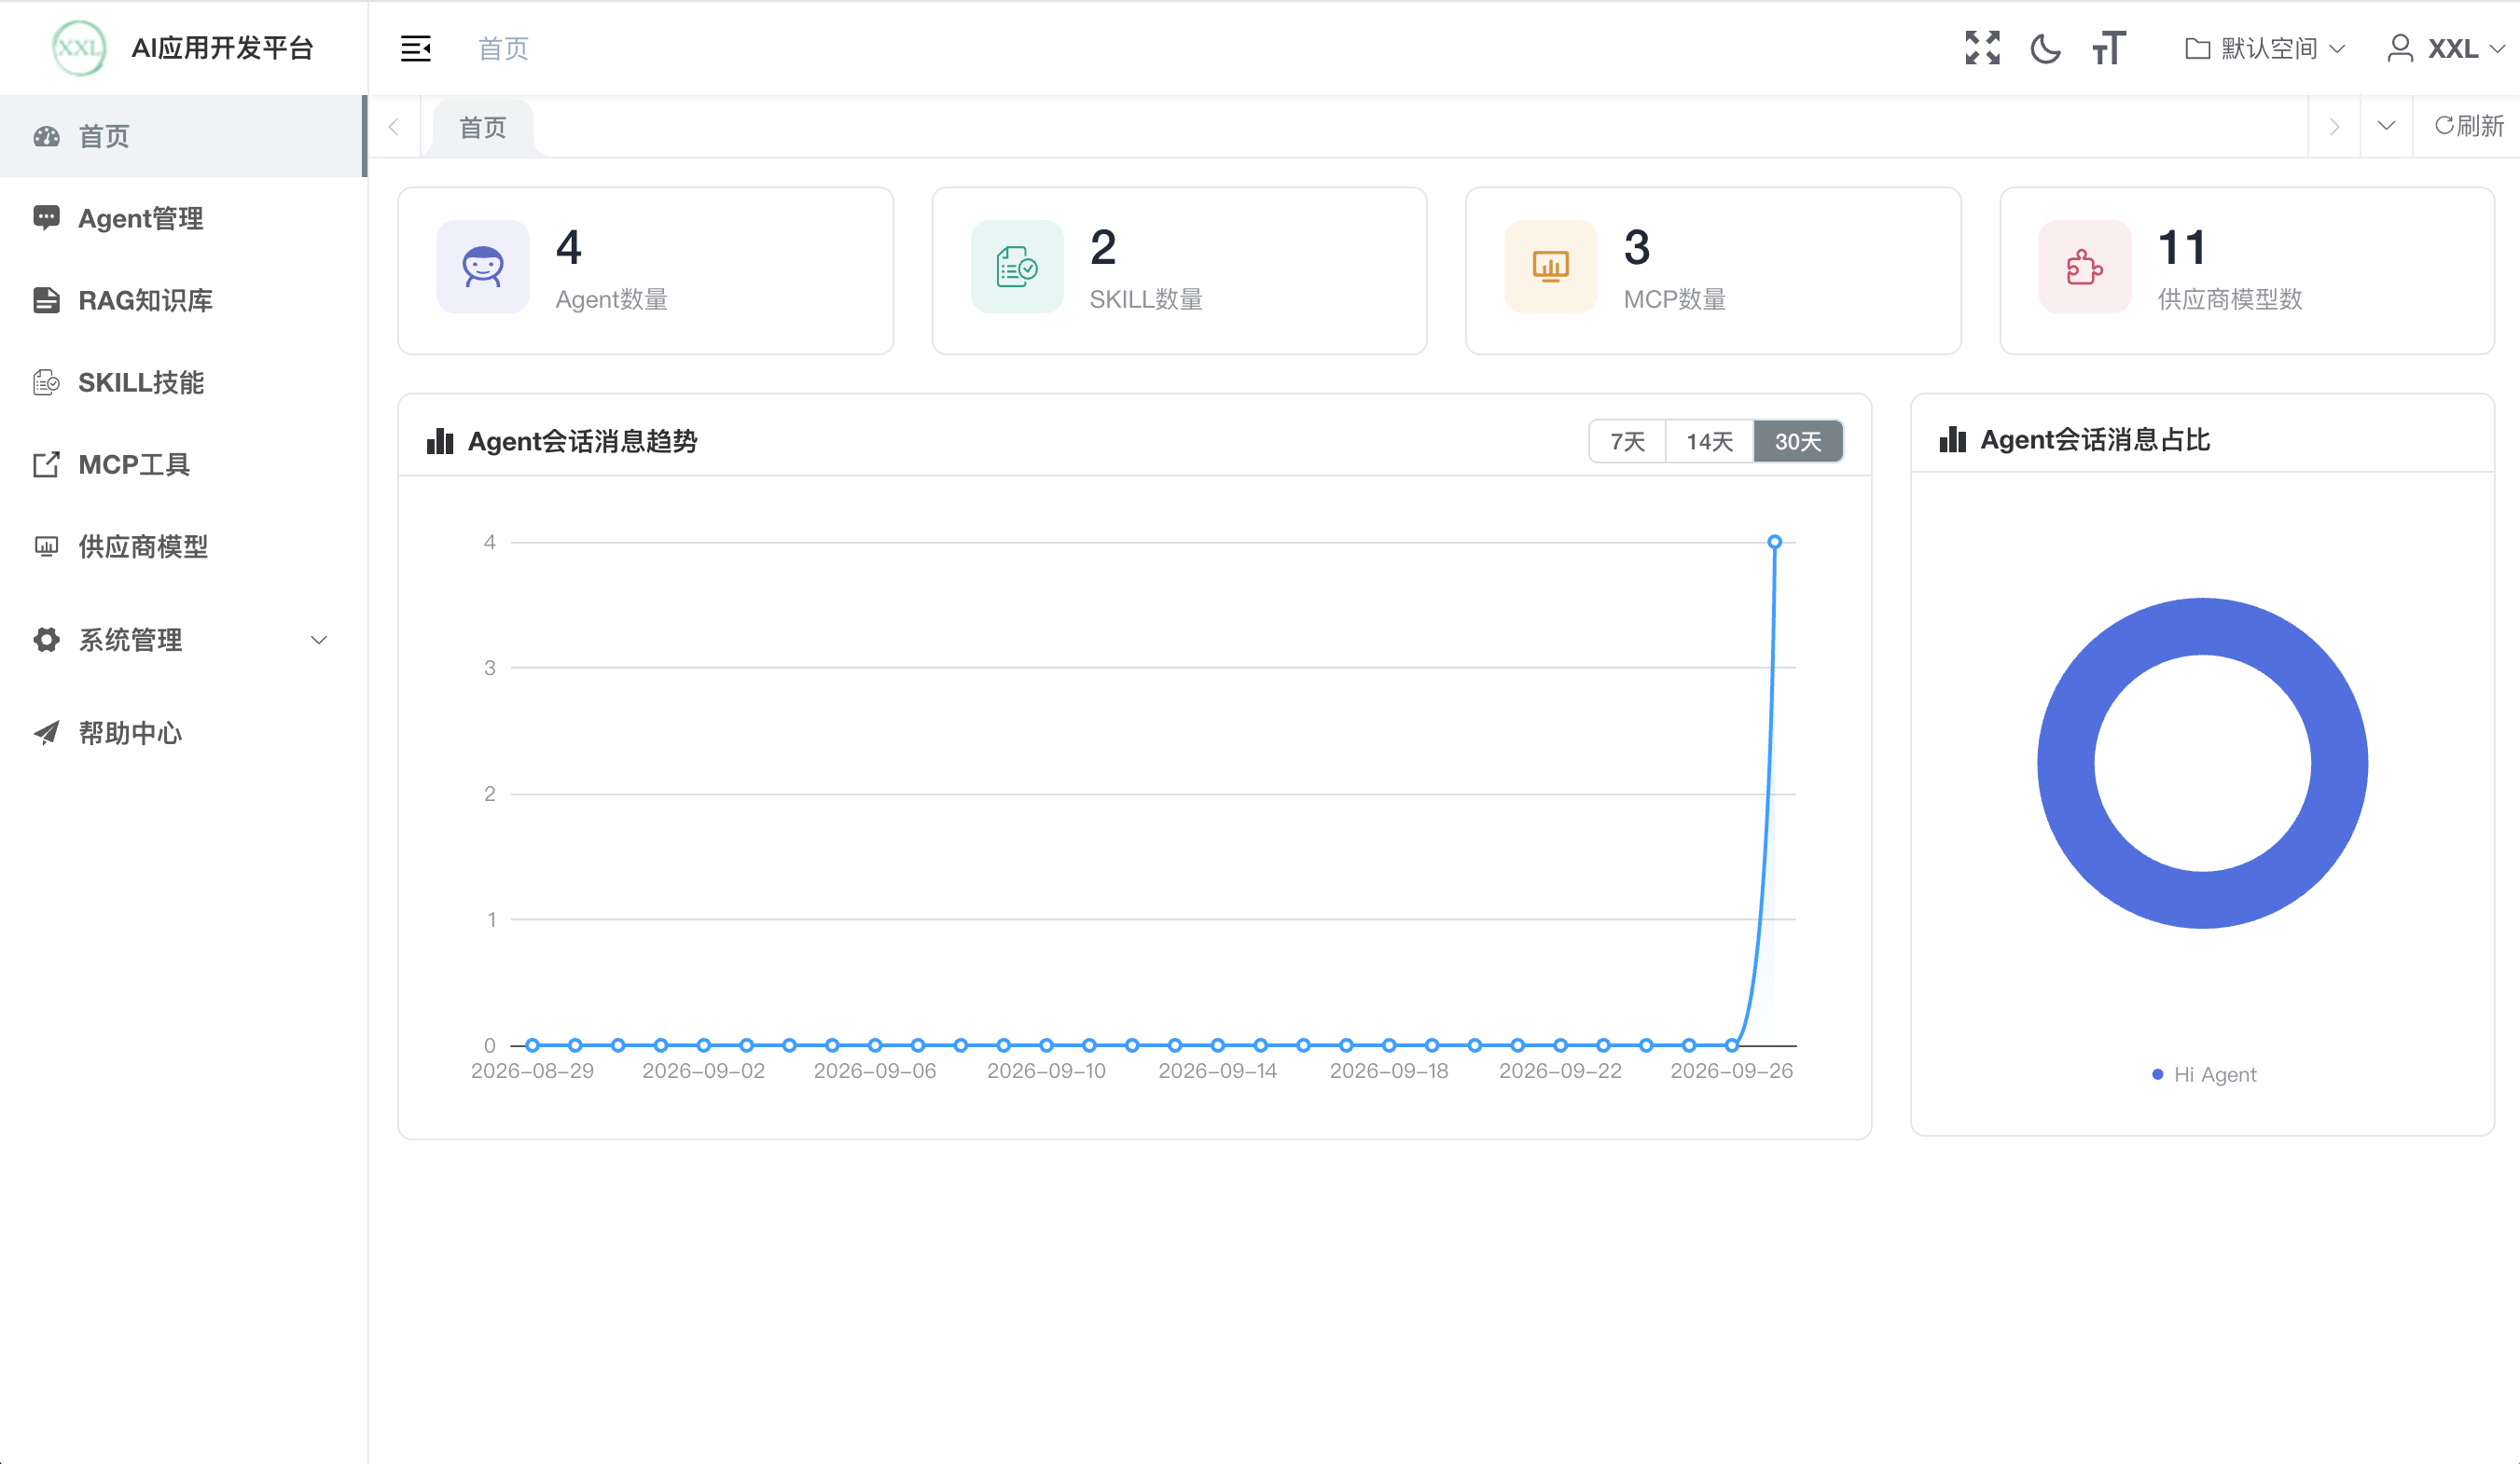
图:工作台:资源统计与 Agent 会话消息趋势(图片来源:XXL-AI 官方文档)
10.3 最小可用路径:8 步跑通一个 Agent
官方文档给的最短链路是「登录 → 供应商/模型 → Agent 编排 → 发布 → 对话」,MCP / SKILL / RAG 都是可选增强:
- 登录管理端,验证码开关由
system.login.captcha.enabled控制;登录后进入工作台,顶部有空间切换器(切换后请求自动带xxl-space-id)。 - 系统管理 → 业务空间:内置「默认空间(default)」,多团队时先建空间并在「用户管理」里给普通用户授权可见空间。
- 供应商模型 → 供应商 → 新增:填名称、OpenAI 兼容
base_url、API Key;可选自定义 Header(value 支持{session})。保存后勾选记录点「连通测试」。 - 进入该供应商的「模型」→ 自动导入:拉取远程
/models列表批量导入,或手工新增。必须至少有一个对话模型;要做 RAG 还需一个嵌入模型。 - Agent 管理 → 新增 → 编排:填系统指令、选对话模型(必选),知识库 / MCP / Skill 先留空。
- 打开「发布」开关:系统生成 UUID,列表出现访问 URL。
- 前往 Agent:访问
/#/chat/{uuid}(免登录),页面自动创建会话,输入问题即可看到流式输出、思考过程折叠、Markdown 渲染。 - 验证断点续传:生成过程中刷新页面,前端发现助手消息
status=0,自动按msgId+lastEventId走/chat/resume,已生成内容不丢。
10.4 给 Agent 装上工具、知识与技能
接 MCP:「MCP工具 → 新增」。远程选 Streamable HTTP 填 URL + Headers;本地选 stdio 填 command / args / env / cwd。最快的方式是直接用仓库自带的示例服务——启动 xxl-ai-sample 后填 http://localhost:8091/sample/mcp,点「测试连接」应看到 get_current_time 与 calculator 两个工具。回到 Agent 编辑弹窗,在「关联 MCP」勾选它,下一轮对话即可让模型调用工具(试试问"现在几点,顺便算一下 (12+8)*3")。
写 SKILL:「SKILL技能 → 新增」,系统自动播种 SKILL.md + scripts/ + reference/ 骨架(三个固定节点不可删改)。进入「内容管理」用文件树 + Markdown 编辑器写操作手册与脚本,例如让 Agent 按固定格式输出日报。保存会刷新 update_time,Agent 下次使用时自动重新物化到 agent_{agentId}/ 目录。
建 RAG 知识库:「RAG知识库 → 新增」,选嵌入供应商/模型,设置分片大小(默认 500)、重叠(50)、检索数量(5)。进入「文档管理」粘贴文本或上传 txt/md,勾选后点「向量化」,状态变「已向量化」并显示分片数;用「向量检索」输入一句话看命中文档与相似度,验证分片与召回效果。确认无误再回 Agent 里勾选该知识库。
调参直觉:中文文档字符级分片,
chunk_size=500时overlap=50偏小,遇到跨段语义可试chunk_size=300~800 / overlap=80~120 / top_k=5~10。因为overlap会被 clamp 到size-1,不会出现死循环,但过大也不会报错,靠「向量检索」验证召回质量来定。
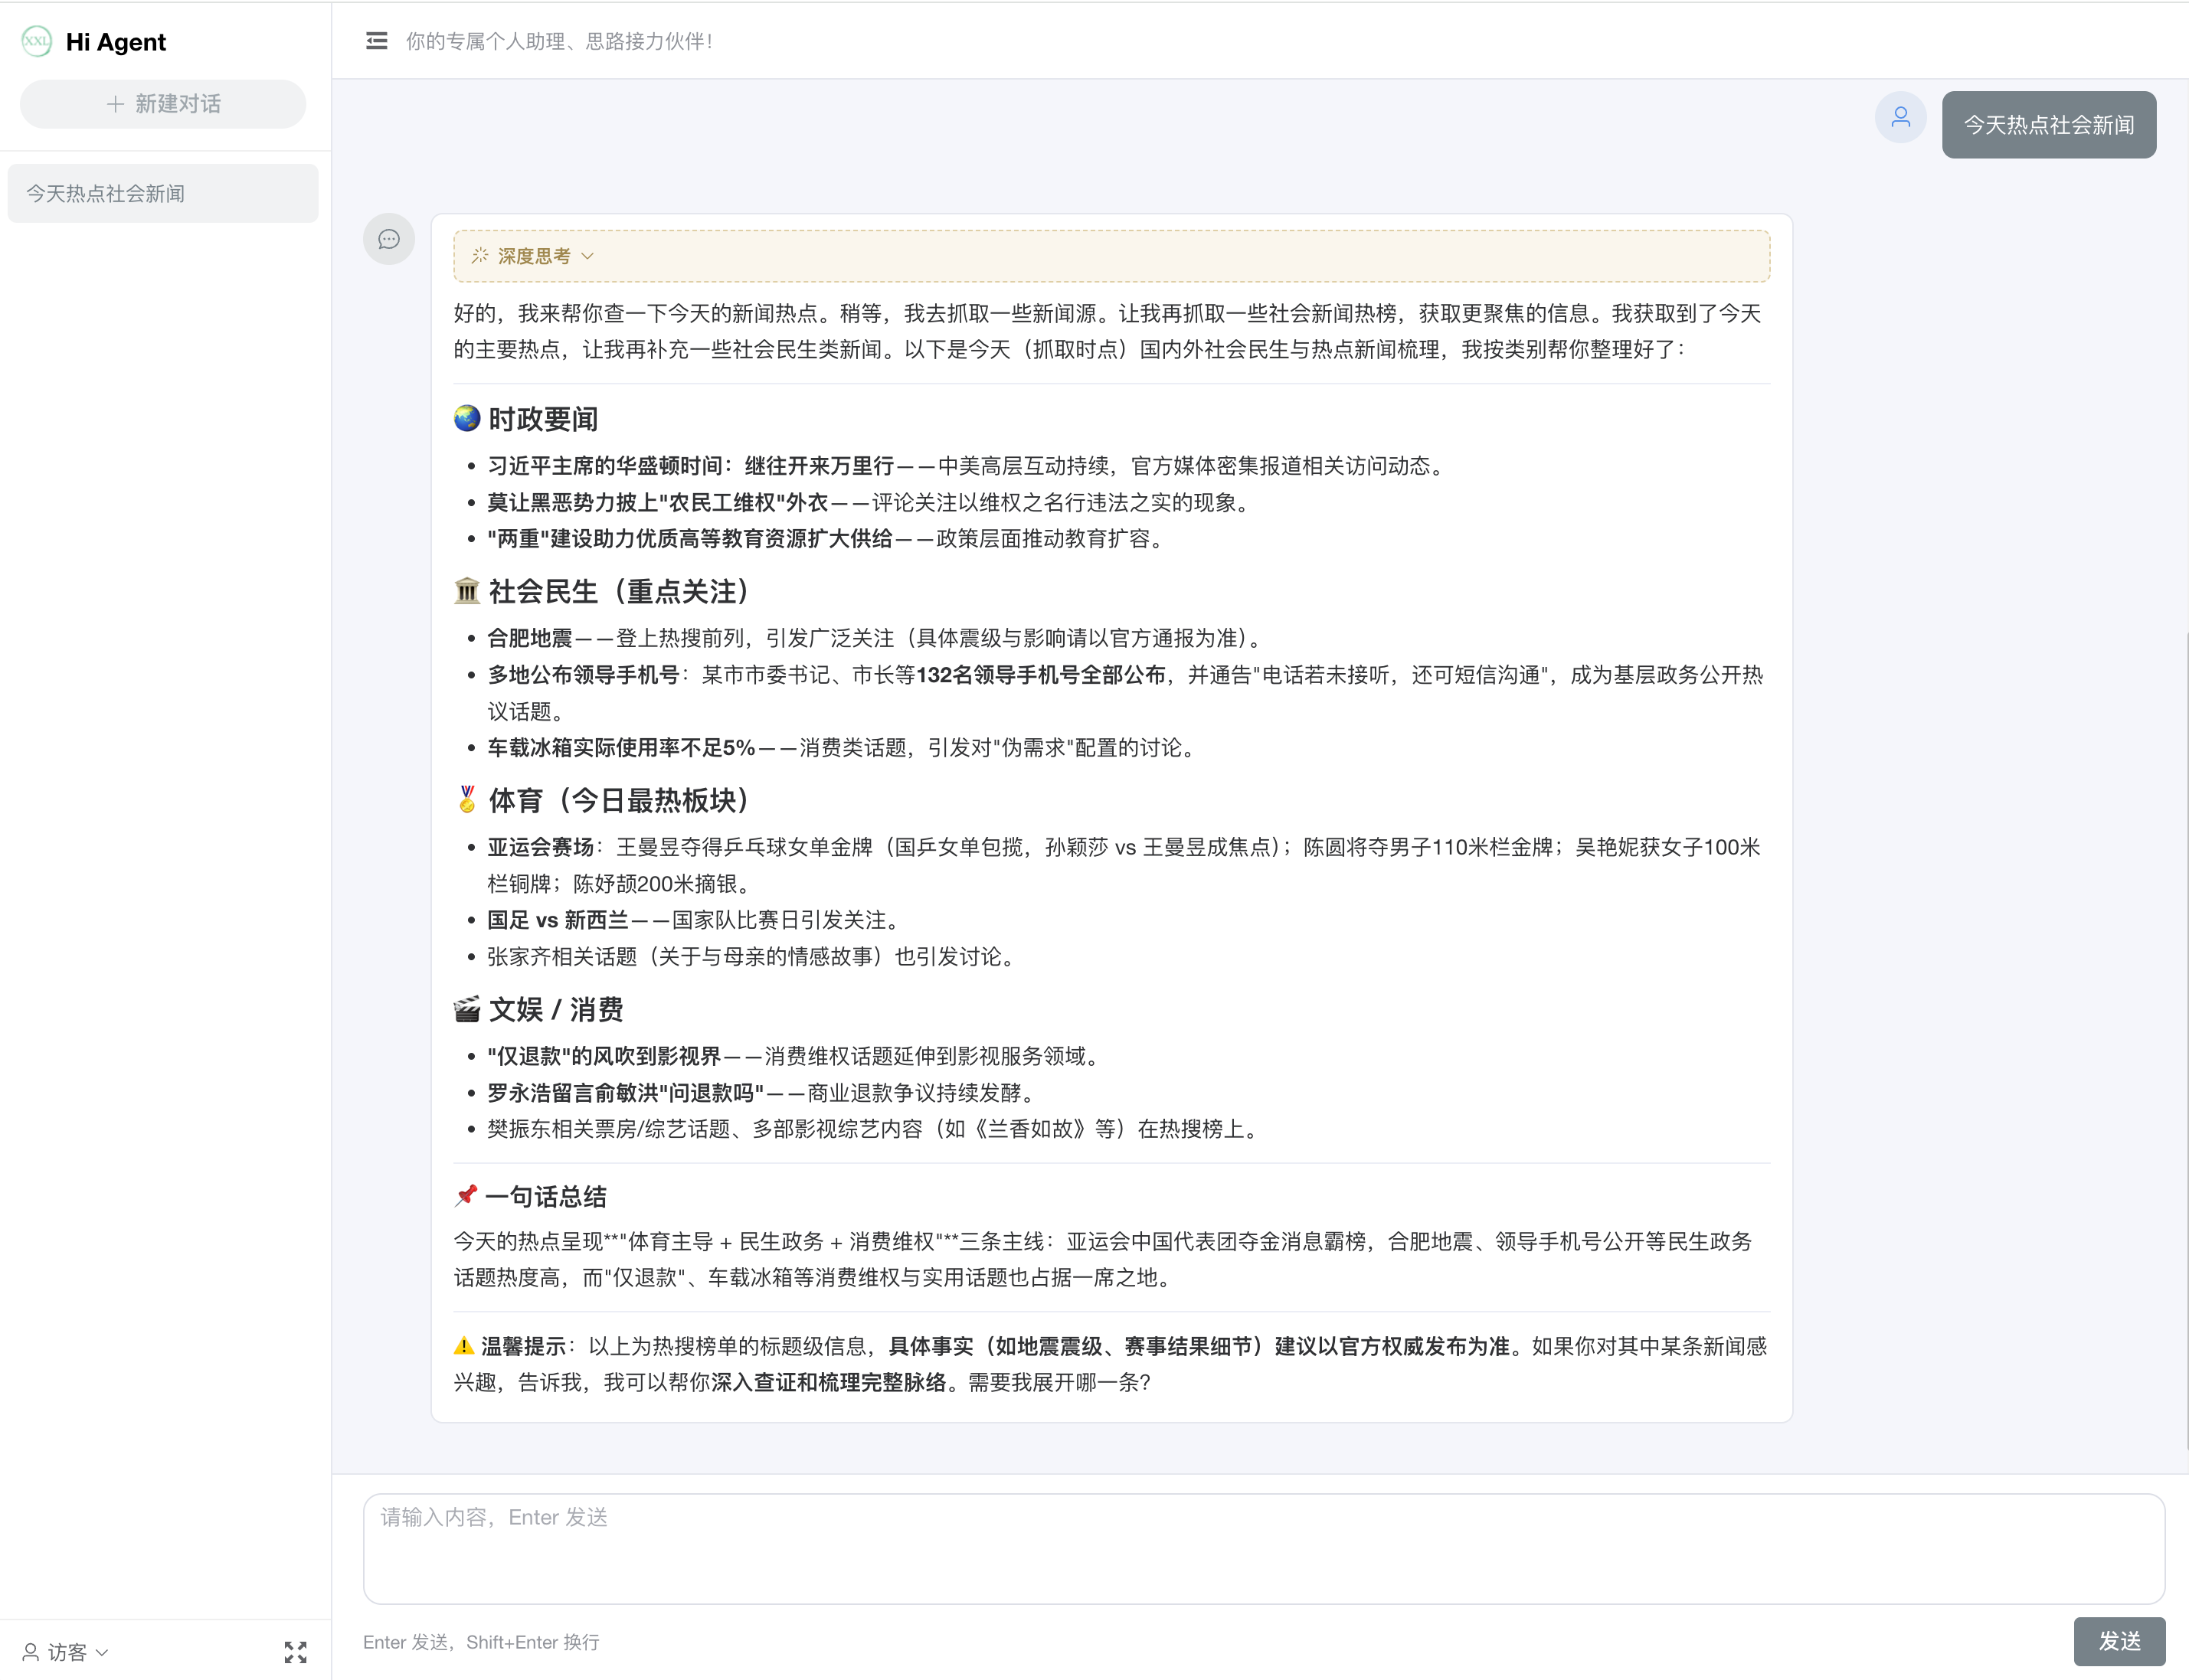
图:对话实例:Agent 调用 MCP 工具多轮协作汇总热点新闻(图片来源:XXL-AI 官方文档)
这张官方示例展示的就是 4.5 讲的装配链路生效后的效果:模型自行决定调用多个 MCP 工具,工具结果回到上下文后再汇总成答案;对话同时支持「深度思考」折叠与 Markdown 实时渲染,生成中刷新或断网会自动断点续传。
10.5 Desk 版:5 步开始在本地工程上干活
cd xxl-ai-desk
npm install          # postinstall 自动下载 Electron 二进制 + 重建 better-sqlite3 / node-pty
npm run dev          # 或 npm run pack 出免安装包
- 首次启动自动预置 OpenCodeGo / Ollama / Deepseek / 智谱GLM 四个供应商,并默认选中首个;到「设置 → 模型供应商」填自己的 API Key(裸地址自动补
/v1)。 - 「系统设置 → 项目」新建项目并选择本地磁盘目录(这是后续所有文件工具的沙箱根);按需打开「长期记忆」。
- 「扩展中心 → Agent」选预设 Agent(通用助手 / 编程助手 / 陪伴交流),或新建并配置系统指令、SKILL、MCP、内置工具分类。
- 回到对话页,新建会话时必选项目 + Agent,输入框左侧选权限档(默认「工作区内修改」)。
- 试着说"帮我看看这个项目的目录结构并总结 README":右侧文件 / Git / 终端 / 浏览器面板可同时打开;越界写入会在输入框内联弹出「允许本次 / 本会话允许 / 拒绝」;输入框底部信息条展示轮次、Token 用量与上下文占用率。
据官方教程补齐的 Desk 操作细节:
- 扩展中心四个子页:Agent(新建/编辑/删除,配置名称、描述、图标、系统指令、SKILL、MCP 与内置工具分类;首次启动预置通用助手 / 编程助手 / 陪伴交流三个 Agent,默认 Agent 不可删除)、MCP 工具(远程/本地管理、连通测试、工具列举与市场发现)、SKILL 技能(目录 / Zip 导入、GitHub 安装、skills.sh 市场)、内置工具(能力目录,是否启用由 Agent 决定);
- 项目与会话:项目 1:1 绑定本地磁盘目录,可重命名、在文件管理器中显示、删除(级联删除会话/消息/记忆);会话必须归属项目并绑定 Agent,创建后归属不可修改;侧栏按项目分组,首条消息即时生成标题;删除项目时长期记忆随项目行一并删除;
- 对话区:输入框左侧三档权限选择器随会话持久化;危险命令规则库始终生效、不随档位放开;输入框「+」可关联项目文件/文件夹,仅随下一条消息下发;
- 设置:常规(外观/主题/语言/全局快捷键)、个性化(应用名称、Slogan)、项目(项目列表、长期记忆开关与内容)、运行设置(Node / Python 运行环境、开发者模式);数据目录默认在系统 userData 下的
xxl-ai-desk.sqlite,可查看/浏览/修改,修改后重启生效。
**macOS 提示"文件损坏"**不是真损坏,是安装包未签名。拖进 /Applications 后执行
sudo xattr -rd com.apple.quarantine /Applications/XXL-AI-Desk.app即可。
10.6 常见坑位速查
| 现象 | 原因 / 处理 |
|---|---|
| 中文 COMMENT / 菜单数据乱码 | 执行 SQL 时客户端默认 latin1,必须 --default-character-set=utf8mb4 |
Compose 起不来,报 lstat .../target |
两个 Maven 模块都要先 mvn clean package,Dockerfile 是 ADD target/*.jar |
| 前端 3000 调接口 404 | 开发态 VITE_APP_BASE_API='/api' 由 Vite 代理剥离;生产态该值必须为空 |
| 页面刷新白屏 | 生产用了 History 路由回退;本项目是 Hash 路由,无需配置回退 |
| RAG 向量化报错但对话仍能聊 | Milvus 不可达时按设计降级跳过;检查 xxl-ai.milvus.uri |
| 模型改了配置不生效 | 检查是否有 {session} Header;模型缓存靠指纹 + 5min 兜底,配置变更应即时失效 |
PORT 环境变量被注入导致端口冲突 |
用命令行参数显式指定 --server.port=8080(命令行优先级最高) |
十一、二次开发:加一个业务模块该把代码放哪
仓库把这件事写成了可执行的规范(.agents/skills/xxl-ai/SKILL.md),标准流程是:
0. 需求落盘:在 xxl-ai-spec/{yyyyMMdd}-{business}/ 建目录,方案写 方案.md(六大块:需求相关 / 数据库设计 / 菜单·授权 / 后端改造 / 前端改造 / 验证结果),SQL 落 {business}-table.sql。
1. 确认需求:模块命名、核心字段、状态枚举、页面形态、菜单与角色授权、验证范围——先确认再写代码。
2. 建表:遵循 xxl_ai_ 前缀、下划线命名、id 自增、add_time/update_time、状态 TINYINT(0正常/1停用)、utf8mb4、i_ 唯一索引前缀、所有字段带 COMMENT、业务表带 space_id、无外键。
3. 后端六件套落 business/{module}:entity / dto / adaptor / mapper / service(+impl) / controller,Mapper XML 落 resources/mapper/business/{module}/。
4. 前端落 modules/business/{module}/:pages/index.vue + api/index.ts + types/index.ts 聚合,跨模块通用件才进 components/。
5. 菜单权限:在 XxlRoleEnum#buildRoleResources 对应角色分支追加一条:
resources.add(res(10, 0, "我的模块", ResourceTypeEnum.MENU,
                  "mymodule:default", "/mymodule/index", "document", 1000));
按钮用 v-hasPermi 复用菜单权限标识;隐藏路由用 resHidden(...)。无需改前端路由表、无需改数据库。
6. 验证:起 8080 + 3000,检查菜单可见、CRUD 可用、权限生效、i18n 中英成对,结果回填 方案.md。
边界判定(最容易踩的一条)
要加的是"一个新的 MCP 工具 / 一个 RAG 检索策略 / 一个新的模型供应商协议"?→ 落
business/harness,命名为XxxTool/XxxClient/XxxFactory,不要写 Controller、不要建元数据表。
要加的是"一张表 + 一套增删改查页面 + 权限菜单"?→ 落business/{module},不要直接 import spring-ai / Milvus / MCP SDK / Redis。
Desk 版对应规范是「进程即目录、网关薄化、契约按域、模块自包含、别名优先」:modules/{domain}/ 下按 shared(DTO/IPC/Api)、main(service/runtime/discover/schema)、preload(DeskApi 片段)、worker(Agent 工具)、renderer(页面/组件/store)、i18n 纵向切分;common 不得反向依赖 @modules/*,渲染层不得引用 @main / @common/main。新增一个内置工具的落位步骤在官方设计文档 6.4.4 写得很细(定义 AgentTool → 声明 meta{group, readOnly, permissionModes, requiresApproval, maxOutput} → 新域才登记 FACTORIES → 前端 catalog.ts 登记文案)。
十二、选型建议与生产落地检查清单
| 你的场景 | 建议 | 理由 |
|---|---|---|
| 企业内部统一建 AI 平台,多团队 / 多业务线 | 云版 | 空间隔离 + RBAC + 集中管理供应商与知识 + 审计日志 |
| 把 Agent 作为对外服务发布给访客 / 第三方 | 云版(但先补网关防护) | 一键 UUID 公开地址 + 访客会话回看;OpenAPI 仍在 TODO |
| 需要集群、高并发、断线续传的生产级流式 | 云版 | SSE 无状态化 + Redis Stream |
| 个人开发者本地写代码、改项目、跑命令 | Desk | 项目沙箱 + 终端 + Git + 文件面板 + 三档权限 |
| 隐私 / 离线 / 数据不出本机 | Desk | 零服务依赖,数据仅落本地 SQLite |
| 复杂工作流 DAG / 条件分支 / 并行编排 | 暂不推荐 | 无工作流引擎,考虑 Dify / Langflow / n8n |
| 文档密集型问答(PDF / 扫描件 / 表格 / 引用溯源) | 暂不推荐 | 目前仅 txt/md + 字符级分片,考虑 RAGFlow / FastGPT |
| 闭源二开做商业分发 | 先做合规评估 | GPLv3 传染性 |
组合用法:团队用云版做统一平台与对外发布,个人用 Desk 做本地编码工作台,两版独立安装、互不依赖。
上线前检查清单:
- [ ]
admin/123456已改,验证码开关按安全要求开启 - [ ] MySQL / Redis 密码、Milvus 鉴权、
xxl-sso.token.key全部替换默认值 - [ ]
xxl-ai.skill.root在集群环境挂共享持久卷 - [ ] 公开端
/chat/**在网关加限流、鉴权、内容审计 - [ ] 按并发量核算
sse.max=64/worker.count=4/stream.timeout=180000/ Redis 连接池max-active=32 - [ ] 评估
/chat/stop单节点终止的局限,必要时改为广播 - [ ] Desk 版若存高价值 Key,把 base64 换成
safeStorage - [ ]
stream.ttl=600是否匹配业务可容忍的续传窗口 - [ ] 确认 RAG 降级策略(知识库不可用时仍可对话)符合业务预期
十三、小结与参考资料
把 XXL-AI 一句话说准:它不是又一个"拖拖拽拽做 Agent"的平台,而是把 XXL 系列十年积累的 Java 中后台底座,接上了 2025—2026 年成型的 MCP / Skills / OpenAI 兼容这三条开放规范,再配一个能直接改本机代码的桌面端。它的技术亮点集中在"工程"而非"智能"——Redis Stream 无状态流式、指纹驱动的缓存失效、harness 分层、三层权限闸门、降级密度、单包部署;它的短板也集中在"平台功能"——工作流、文档解析、OpenAPI、云版可观测仍在 TODO。
对 Java 团队来说,这个组合的价值很直接:你不需要为了上一个 AI 应用,先在旁边养一套 Python 服务、再补一遍登录权限和多租户。
参考资料
- 项目仓库:https://github.com/xuxueli/xxl-ai
- 中文官方文档:https://www.xuxueli.com/xxl-ai/
- 仓库内完整文档:
doc/XXL-AI官方文档.md(本文大量设计描述与之交叉校验) - 数据库脚本:
doc/db/tables_xxl_ai.sql - 开发规范:
AGENTS.md、.agents/skills/xxl-ai/SKILL.md、.agents/skills/xxl-ai-desk/SKILL.md - MCP 规范 2025-03-26 变更日志:https://modelcontextprotocol.io/specification/2025-03-26/changelog
- MCP 发布公告:https://www.anthropic.com/news/model-context-protocol/
- Dify LICENSE:https://github.com/langgenius/dify/blob/main/LICENSE
- Coze Studio:https://github.com/coze-dev/coze-studio
- Langflow:https://github.com/langflow-ai/langflow
- FastGPT LICENSE:https://github.com/labring/FastGPT/blob/main/LICENSE
- RAGFlow:https://github.com/infiniflow/ragflow
- n8n 社区许可:https://docs.n8n.io/n8n-community-license
- Spring AI Alibaba:https://github.com/alibaba/spring-ai-alibaba ;AgentScope Java:https://github.com/agentscope-ai/agentscope-java
- 社区介绍文:https://www.cnblogs.com/xuxueli/p/23137054
写在最后:本文所有版本号、常量、类名、表字段均以 2026-11-08 的 master(
1854b1e)为准。项目迭代很快(6 周 8 个版本),读到本文时若有出入,以源码为准——这也是我建议你看源码而不是只看文档的原因。